SEO et IA
Robots.txt et IA : protéger son contenu sans casser son SEO
Publié le
Google prépare un signal commun pour refuser l'entraînement des IA. Faut-il déjà modifier ton robots.txt ? Voici comment protéger ton contenu sans confondre entraînement, indexation et visibilité.
Tu publies un article, une page de service ou un comparatif. Puis tu apprends qu'un robot peut consulter ton travail pour alimenter des systèmes d'intelligence artificielle. Réflexe : bloquer tous les robots pour protéger tes textes ? Ce serait risquer de fermer la porte aux personnes qui pourraient devenir tes clients.
Le 30 octobre 2026, Google a annoncé son intention de prendre en charge un signal commun dans robots.txt pour exprimer une préférence concernant l'entraînement des modèles. Mais le calendrier est essentiel : Google vise 2027. Le nouveau mécanisme n'est pas un bouton universel déjà opérationnel.
Alors que faire aujourd'hui ? Pas une modification précipitée. Tu vas distinguer recherche, entraînement et utilisation comme référence, choisir ce qui compte pour ton activité et préparer sept contrôles avant de toucher à la configuration.
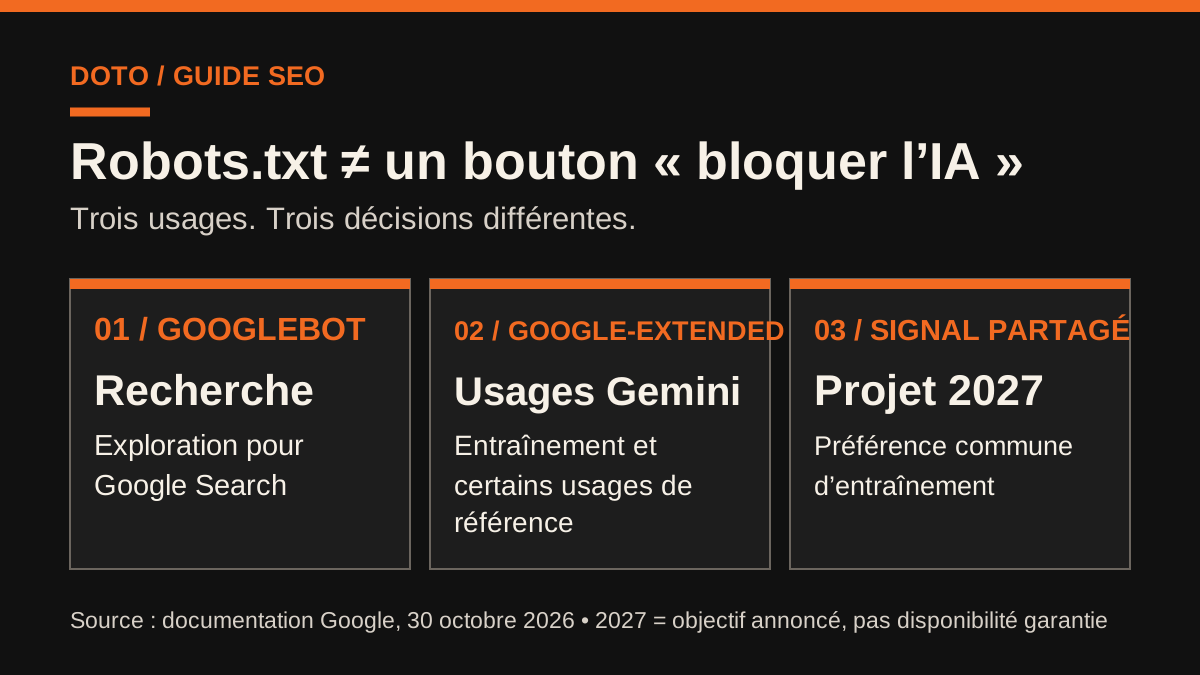
L'annonce du 30 octobre 2026 : ce qui change vraiment
Dans sa publication officielle du 30 octobre, Google présente un projet de signal partagé issu des travaux AIPREF à l'IETF. L'idée : permettre aux éditeurs d'exprimer une préférence d'entraînement auprès de plusieurs fournisseurs à partir d'un mécanisme commun, plutôt que d'accumuler des règles différentes.
Google indique qu'un refus via ce futur signal serait interprété comme un refus de Google-Extended si ce dernier n'est pas explicitement configuré. Les choix propres à chaque fournisseur continueraient à coexister avec le signal partagé. Les discussions de standardisation se poursuivent.
Retenons trois choses. D'abord, l'annonce est une intention de prise en charge en 2027, pas une preuve de fonctionnement aujourd'hui. Ensuite, les contrôles existants ne disparaissent pas. Enfin, un signal partagé ne garantit pas qu'un robot inconnu ou non coopératif le respectera.
Si tu tiens un site de business, ce changement mérite une veille et une décision documentée. Il ne justifie pas de modifier ton robots.txt sans avoir compris ses règles actuelles.
Pourquoi robots.txt ne règle pas toutes les questions d'IA
Un même contenu peut être exploré pour apparaître dans un moteur, être utilisé pour entraîner un modèle ou servir de référence dans une réponse. Ces trois opérations n'ont pas les mêmes objectifs. Un réglage utile pour l'une peut être sans effet sur une autre.
Exploration et indexation dans la recherche
Googlebot explore les pages accessibles afin d'alimenter Google Search. Interdire à Googlebot l'accès à l'ensemble de ton site peut empêcher la lecture de tes pages utiles. Tu risques alors de compliquer leur découverte par les internautes.
Mais bloquer l'exploration n'est pas une demande de désindexation. Selon la documentation officielle de robots.txt, une URL interdite à l'exploration peut parfois encore apparaître dans les résultats, sans que Google ait lu son contenu. Ne confonds jamais les deux mécanismes.
Entraînement des modèles
L'entraînement consiste à utiliser des données pour développer ou améliorer un modèle. Des fournisseurs proposent des préférences techniques, dont Google-Extended. Le projet annoncé en octobre vise une expression plus commune de ce choix.
Une directive robots.txt n'est pourtant ni un mot de passe ni une protection absolue du droit d'auteur. Elle n'empêche pas nécessairement un acteur non coopératif de consulter une page publique. Elle ne retire pas automatiquement les copies déjà obtenues.
Réponses générées et références
Un système d'IA peut aussi utiliser une source pour étayer une réponse. Google explique que Google-Extended couvre certains usages de grounding dans Gemini Apps et Vertex AI. Ces usages ne se confondent pas avec l'indexation dans Google Search.
C'est pourquoi il faut lire la portée exacte de chaque contrôle. Dire « je bloque l'IA » est trop vague pour prendre une bonne décision technique.
Google-Extended : l'effet réel sur ton SEO
Dans sa liste officielle des robots, Google décrit Google-Extended comme un jeton de contrôle pour certains usages de contenus par les produits Gemini. Il ne s'agit pas d'un robot HTTP séparé qui apparaît toujours sous son propre nom dans les journaux : l'exploration peut être effectuée par des robots existants.
Google précise que Google-Extended n'affecte pas l'inclusion dans Google Search et n'est pas un signal de classement pour ce moteur. C'est une information importante pour un entrepreneur qui cherche à conserver son trafic organique.
Attention à l'autre moitié de la phrase : le choix peut avoir des conséquences sur certains usages de référence dans des produits Gemini. Il serait donc incorrect de dire qu'il n'a aucun effet possible sur la visibilité au sens large.
La bonne approche consiste à comparer deux objectifs : être découvert dans la recherche et choisir les usages d'entraînement ou de référence. Ce ne sont pas des boutons interchangeables.
Pourquoi ça marche : décider à partir de la valeur de tes pages
Une page de vente cherche à obtenir des contacts. Un article de blog peut attirer des visiteurs qualifiés. Une documentation publique aide des clients. Un dossier confidentiel doit rester inaccessible sans autorisation. Ces contenus ne demandent pas tous la même stratégie.
| Contenu | Objectif principal | Question décisive |
|---|---|---|
| Article public | Être découvert | Le moteur peut-il accéder au guide ? |
| Page d'offre | Générer des demandes | Le blocage risque-t-il de réduire la découverte ? |
| Documentation publique | Informer et rassurer | Quels usages du texte sont acceptables ? |
| Espace client | Réserver l'accès | L'authentification est-elle efficace ? |
| Document interne | Protéger des données | Pourquoi le fichier serait-il public ? |
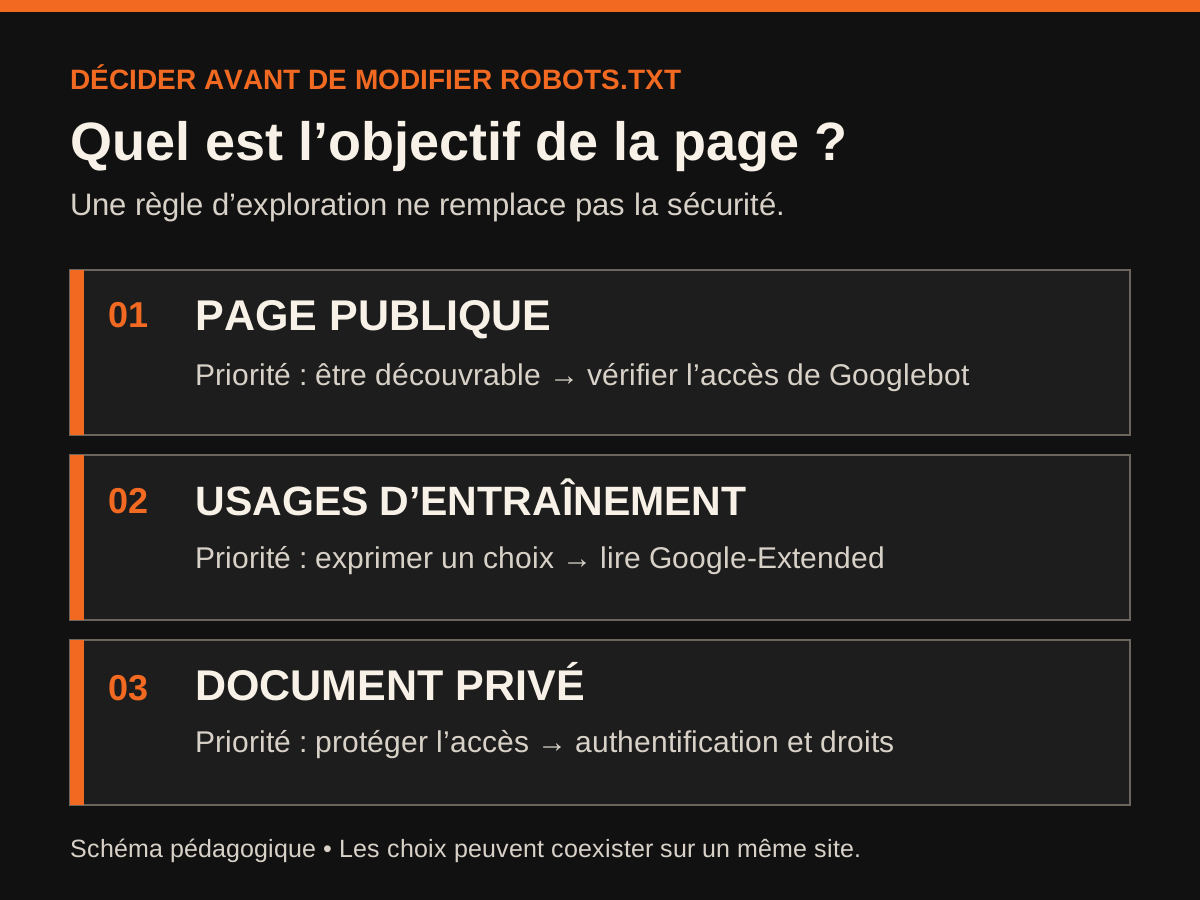
Cette matrice ne remplace pas un audit juridique ou technique. Elle évite une erreur fréquente : choisir une règle de robot avant de savoir à quoi sert la page.
Si ton offre n'est pas encore claire, choisis d'abord une idée de business cohérente. Un site parfaitement configuré ne crée pas une demande qui n'existe pas.
Quatre situations, quatre décisions différentes
Tu lances ton premier site
Tu as quelques pages et très peu de visiteurs. Ton principal risque n'est probablement pas de perdre une guerre invisible contre les robots. C'est que personne ne comprenne ce que tu proposes. Vérifie les pages essentielles, leur accès et leur contenu.
Le guide SEO pour un blog d'entreprise te donne une base plus utile qu'une modification improvisée de robots.txt. Note ta préférence concernant l'entraînement, puis traite-la séparément.
Tu publies des recherches originales
Tu réalises des entretiens, des comparatifs ou des analyses que d'autres ne peuvent pas produire rapidement. Il est raisonnable d'examiner les conditions d'utilisation de tes travaux et les contrôles disponibles.
Sépare ce qui est librement accessible, ce qui fait l'objet d'une licence et ce qui doit rester réservé. Ne te contente pas d'une directive de crawl pour protéger une ressource qui ne devrait jamais être publique.
Tu vends un service ou un logiciel
Tes pages commerciales doivent être compréhensibles et découvrables. Un blocage général peut aller à l'encontre de ton objectif. Vérifie d'abord la qualité de la page qui présente ton offre et la cohérence de son appel à l'action.
Si tu veux limiter certains usages d'entraînement, fais-le en connaissance de cause, sans confondre les règles des moteurs et celles des autres produits IA.
Tu stockes des documents privés
Devis clients, contrats, informations personnelles : ici, le sujet principal est la sécurité. Une authentification adaptée, des droits limités et un hébergement maîtrisé sont indispensables.
Robots.txt est public. Il indique aux robots coopératifs ce qu'ils devraient explorer. Ce n'est pas un coffre-fort. Si une donnée est sensible, ne la laisse pas accessible simplement parce qu'une directive demande aux robots de l'ignorer.
Le futur signal commun de 2027 : ce qu'il ne faut pas inventer
L'annonce d'octobre évoque un mécanisme partagé en cours de standardisation. Elle ne dit pas que tous les fournisseurs l'ont déjà déployé, ni qu'un site l'appliquant aujourd'hui sera automatiquement protégé.
Un exemple de configuration trouvé sur un forum peut sembler convaincant. Pourtant, une règle inconnue peut être ignorée ; une règle trop large peut bloquer une partie du site. Copier sans comprendre est une mauvaise méthode, même quand le fichier paraît minuscule.
Distingue la date de l'annonce, la date de prise en charge visée et la date à laquelle chaque fournisseur confirmera son implémentation. Elles ne sont pas nécessairement identiques.
En novembre 2026, la décision prudente consiste à documenter la préférence souhaitée, utiliser uniquement des contrôles dont les effets sont confirmés et réexaminer le projet quand la prise en charge commune sera effectivement annoncée. Un calendrier prévisionnel peut changer.
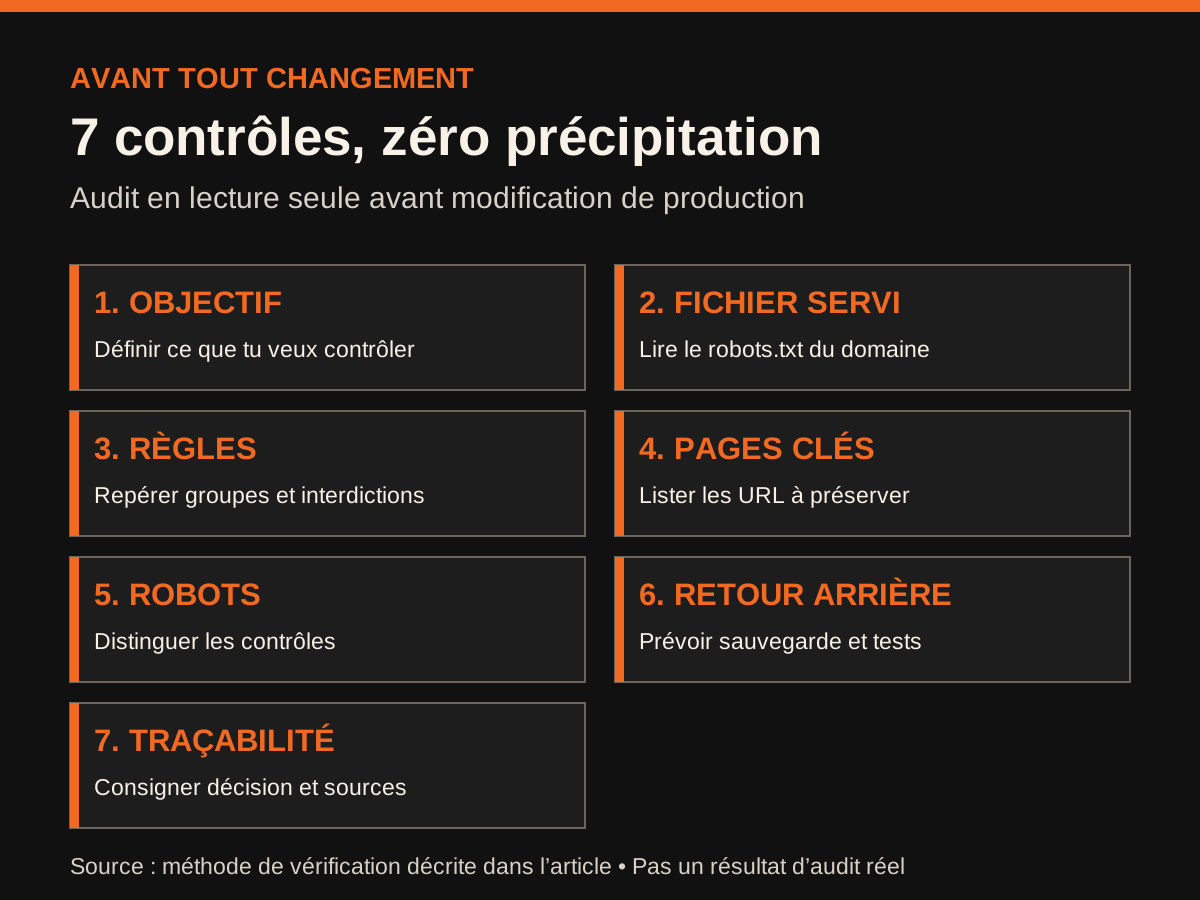
Sept contrôles avant toute modification de robots.txt
Tu peux faire cet audit sans écrire une seule ligne en production. Prépare une copie du fichier, puis vérifie les points suivants.
- Définir l'objectif. Cherches-tu à conserver l'indexation, refuser un usage d'entraînement, protéger une ressource privée ou corriger une erreur d'exploration ? Une règle ne doit pas prétendre tout faire.
- Identifier le fichier réellement servi. Le robots.txt attendu est à la racine du domaine. Celui du dépôt n'est pas forcément identique à celui que les robots reçoivent.
- Lire les règles actuelles. Relève les groupes de robots, les chemins autorisés, les interdictions et les éventuelles références au sitemap.
- Repérer les pages indispensables. Accueil, services, articles importants et contact doivent rester accessibles aux moteurs que tu souhaites accueillir.
- Séparer les contrôles. Googlebot et Google-Extended ont des fonctions distinctes. Consulte leurs documentations actuelles avant de rédiger une règle.
- Prévoir un retour arrière. Conserve la version précédente, teste les changements envisagés et définis comment restaurer rapidement le fichier.
- Consigner la décision. Note la source officielle, sa date, le responsable du changement et les résultats attendus. Prévois une nouvelle vérification en 2027.
Si ton site comporte de nombreux guides, le maillage interne SEO mérite aussi un contrôle. L'accès des robots ne compense pas une architecture qui empêche les lecteurs de trouver la suite logique.
Comment l'appliquer dès aujourd'hui en trente minutes
Dix premières minutes : liste cinq URL : accueil, page de service, deux guides et une ressource réservée éventuelle. Pour chacune, indique si elle doit être publique ou protégée. Si la réponse est incertaine, ne change rien.
Dix minutes suivantes : examine en lecture seule le robots.txt réellement livré par ton domaine. Compare-le au fichier versionné, si tu en as un. Cherche les règles générales trop larges, les exceptions incomprises et les références à des robots précis.
Dix dernières minutes : rédige une fiche de décision. Elle doit contenir ton objectif, les pages concernées, les effets recherchés, les risques, les sources officielles et un plan de vérification. Tu peux ensuite demander une revue technique ciblée.
Cette demi-heure ne remplace pas un test. Elle te protège surtout contre une action impulsive qui pourrait toucher tout ton site. Et elle te laisse du temps pour valider la demande réelle de ton projet, ce qui reste une priorité commerciale.
Exemple fictif : une agence avec vingt guides
Imagine une petite agence qui publie vingt articles pratiques et reçoit des demandes de devis depuis son site. Elle conserve aussi des contrats clients dans un espace privé. Elle découvre l'annonce sur le futur signal commun et décide d'agir.
La mauvaise réaction serait de bloquer toute exploration pour « protéger l'IA ». Les pages commerciales pourraient devenir plus difficiles à découvrir. Autre erreur : laisser les contrats sur une URL publique en pensant que robots.txt suffira à les cacher.
Dans cet exemple fictif, l'agence commence par séparer les zones. Les pages commerciales restent accessibles aux moteurs souhaités ; les documents clients sont protégés par authentification. L'équipe étudie ensuite Google-Extended et note sa préférence concernant l'entraînement, sans présumer que le signal commun est déjà disponible.
Le critère de réussite est concret : les pages publiques restent accessibles, les ressources privées ne le sont pas, et chaque choix est documenté. Il n'y a ni promesse de trafic supplémentaire ni garantie universelle de protection.
Erreurs courantes qui peuvent coûter cher
Bloquer tout le domaine par peur. Une règle générale peut compromettre la découverte de ton offre. Commence par la liste des pages importantes.
Confondre robots.txt et sécurité. Les robots malveillants ne sont pas tenus de respecter une préférence. Les ressources privées exigent un véritable contrôle d'accès.
Déployer un mécanisme annoncé pour 2027 comme s'il était actif. Attends des preuves de prise en charge et de comportement réel.
Mélanger Googlebot et Google-Extended. Leurs rôles sont différents ; leurs conséquences doivent être évaluées séparément.
Attribuer toute baisse de trafic au fichier. Une variation de clics peut avoir plusieurs causes. Compare les périodes et les pages avant de conclure.
Modifier sans sauvegarde. Une petite erreur de configuration peut être pénible à diagnostiquer. Garde un historique et un moyen de revenir en arrière.
Oublier le client. L'objectif final est une demande qualifiée, une inscription utile ou une vente. Le fichier robots.txt n'est qu'un élément de l'ensemble.
Questions fréquentes sur robots.txt et l'IA
Peut-on empêcher l'entraînement des IA avec robots.txt ?
Certains fournisseurs proposent des contrôles documentés, dont Google-Extended. Google a annoncé un signal commun le 30 octobre 2026 avec une prise en charge visée pour 2027. Aucun contrôle ne garantit le respect par tous les robots.
Bloquer Google-Extended fait-il perdre son référencement Google ?
Google indique que Google-Extended n'affecte pas l'inclusion dans Google Search et n'est pas un signal de classement. Il peut toutefois concerner certains usages de contenus par les produits Gemini.
Robots.txt protège-t-il un espace client ?
Non. Robots.txt est un fichier public de consignes d'exploration. Pour des données privées, il faut une authentification, des permissions et des protections adaptées.
Faut-il utiliser dès maintenant le nouveau signal partagé ?
Pas en supposant qu'il est déjà universellement pris en charge. Google annonce une mise en œuvre visée en 2027. Vérifie l'état des spécifications et des implémentations avant tout changement.
Comment vérifier une modification sans casser le SEO ?
Sauvegarde le fichier, identifie les pages prioritaires, teste les règles envisagées et contrôle les URL après déploiement. Ne change pas la production si les conséquences restent incertaines.
Conclusion : protège ton travail sans fermer ta vitrine
L'annonce de Google pose une question légitime : quels usages de tes contenus veux-tu autoriser ? Elle ne justifie pas de bloquer ton site dans la précipitation. En novembre 2026, le signal commun reste un projet annoncé pour 2027.
Sépare la visibilité de ton activité, la protection des ressources privées et les préférences d'entraînement. Documente tes décisions, vérifie les sources et ne modifie que ce que tu comprends.
Si tu construis encore ton projet, garde le cap : une idée, un test, une action concrète. DO TO DAY propose des missions guidées pour avancer étape par étape. Ne laisse pas un fichier technique devenir une distraction de plus.
Ressources complémentaires
- Google Search Central : annonce du 30 octobre 2026, pour la portée du futur signal.
- Google : liste des robots et Google-Extended, pour les effets des contrôles.
- Google : fonctionnement de robots.txt, pour les règles et leurs limites.
- SEO d'un blog d'entreprise, pour les bases de visibilité.
Sources et limites
Au 2 novembre 2026, signal commun annoncé mais prise en charge visée pour 2027 ; aucune garantie de respect par tous les robots. Exemple d'agence fictif. Pas de conseil juridique ni de changement de configuration en production.
- Google Search Central — Supporting a shared AI training control for websites, 30 octobre 2026
- Google Crawling Infrastructure — Google's common crawlers, Google-Extended
- Google Crawling Infrastructure — How Google interprets the robots.txt specification
Passer à l’action
Transforme ta lecture en prochaine étape.
Choisis une mission, suis les étapes une par une et garde ta progression au même endroit avec DO TO DAY.
Commencer gratuitementBêta gratuite. Les résultats dépendent du projet et de son exécution.