SEO & contrôle des IA
Robots.txt et IA : protéger tes contenus sans bloquer Google
Publié le
Google a annoncé son intention de reconnaître un signal commun de préférence pour l'entraînement des IA en 2027. Avant de toucher à robots.txt, comprends ce qui existe déjà, ce qui reste une proposition et comment préserver ta visibilité sans faire de promesses impossibles.
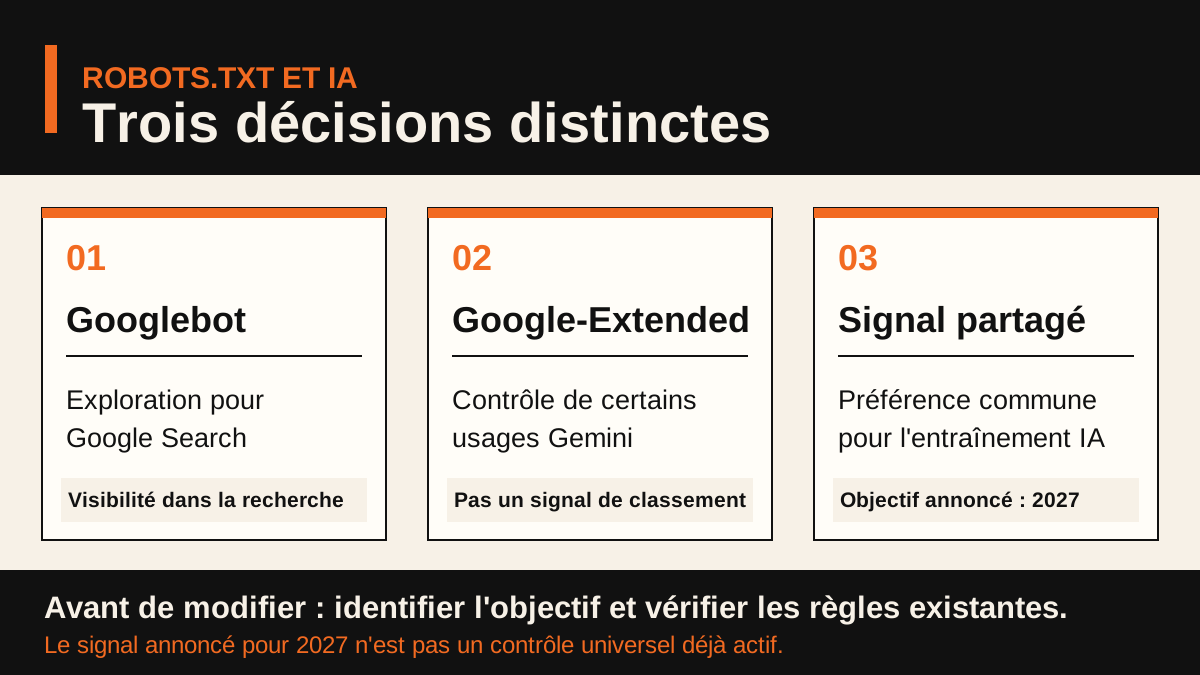
Une annonce du 30 octobre, pas un réglage déjà universel
Le 30 octobre 2026, Google a annoncé son intention de prendre en charge un signal commun de préférence pour l'entraînement des intelligences artificielles dans robots.txt. L'idée est de permettre aux propriétaires de sites d'exprimer un choix général sans multiplier les consignes propres à chaque fournisseur d'IA. La proposition s'appuie sur les travaux du groupe AIPREF à l'IETF.
Le détail décisif : Google vise 2027 pour cette prise en charge. Au 2 novembre 2026, présenter ce mécanisme comme une commande déjà comprise par tous les robots serait trompeur. Il s'agit d'un projet de compatibilité et de normalisation, pas d'un bouton universel disponible aujourd'hui.
Google précise aussi que les contrôles propres aux fournisseurs continueront de fonctionner. Google-Extended existe déjà. Le futur signal commun pourrait coexister avec lui. Pour un indépendant qui publie des articles, un portfolio ou des ressources originales, cette distinction change la décision à prendre.
Le 30 octobre est la date de publication de l'annonce ; 2027 correspond à l'objectif futur de prise en charge. La page officielle ne donne pas d'heure fiable de publication. Aucun événement « survenu dans les dernières heures » ne peut donc être affirmé.
Lis l'annonce officielle de Google Search Central avant de reprendre un conseil circulant sur les réseaux.
Trois usages différents de tes pages
Un moteur peut explorer une page pour l'indexer dans la recherche. Un assistant peut utiliser des informations issues du web pour répondre à une question. Un fournisseur peut employer des contenus dans l'entraînement de modèles. Ces opérations sont différentes, même lorsqu'elles concernent le même article.
Premier piège : croire que refuser certains usages d'entraînement signifie nécessairement disparaître de Google Search. Ce n'est pas ce qu'indique Google pour Google-Extended. Deuxième piège : croire qu'autoriser l'exploration par Googlebot règle automatiquement toutes les questions d'utilisation des contenus.
Imagine une photographe indépendante. Elle souhaite que ses prestations restent trouvables, mais veut examiner séparément l'usage de ses textes et images pour des systèmes d'IA. Sa réponse ne tient pas dans un simple « autoriser » ou « bloquer ». Elle doit distinguer ses objectifs, les commandes existantes et leurs limites.
Commence donc par classer tes pages : acquisition de clients, présentation de service, documentation gratuite, espace réservé ou portfolio. Une page de présentation de service n'a pas nécessairement le même rôle qu'un document contractuel privé.
Robots.txt n'est pas un coffre-fort
Le fichier robots.txt se trouve à la racine d'un site. Les robots qui respectent ce protocole y lisent des indications sur les chemins qu'ils peuvent explorer. Les directives courantes comprennent User-agent, Allow et Disallow. Elles concernent l'accès par exploration, pas une garantie de confidentialité.
Si une URL contient des informations sensibles, robots.txt ne les protège pas. Une personne peut connaître et ouvrir l'adresse, et certains robots peuvent ignorer les consignes. Pour un espace privé, il faut des droits d'accès appropriés. Pour une page publique que tu ne souhaites pas indexer, la stratégie doit être étudiée séparément : empêcher l'exploration peut empêcher un moteur de lire une directive noindex placée dans la page.
Autre détail : le fichier s'applique à un hôte, un protocole et un port donnés. Une règle destinée au domaine principal ne s'applique pas automatiquement à tous les sous-domaines. Google peut aussi mettre robots.txt en cache, ce qui interdit de promettre un effet instantané.
La documentation officielle sur robots.txt décrit ces limites. Si tu n'es pas responsable du site, ne modifie rien : rédige une recommandation, demande une autorisation et prévois un retour arrière.
Googlebot et Google-Extended ne jouent pas le même rôle
Googlebot participe à l'exploration du web pour Google Search. Google-Extended est un jeton de contrôle dans robots.txt concernant certains usages des contenus par Google : notamment l'entraînement de futures générations de modèles Gemini et certains usages de grounding dans les services Gemini.
Google indique explicitement que Google-Extended ne modifie pas l'inclusion d'un site dans Google Search et n'est pas un signal de classement. Dire « bloquer Google-Extended détruit ton SEO » serait donc une généralisation non étayée.
Attention à l'excès inverse. Le réglage concerne aussi certains usages d'ancrage des réponses dans Gemini Apps et des services associés. Le restreindre peut avoir des effets sur ces expériences, même si la recherche classique reste distincte. Autoriser un usage ne garantit d'ailleurs ni citation, ni clic, ni vente.
Pour chaque décision, demande-toi : veux-tu préserver la découvrabilité dans Search, limiter certains usages par les modèles, ou favoriser certaines possibilités de citation ? Tu peux avoir plusieurs objectifs, parfois en tension.
La liste officielle des robots Google détaille leurs fonctions. Ne suppose pas que les autres fournisseurs interprètent automatiquement les mêmes consignes.
Ce que Google envisage pour 2027
La proposition décrit un jeton de politique partagé dans robots.txt. Lorsqu'un site exprime avec ce signal un refus de l'entraînement et ne spécifie pas explicitement Google-Extended, Google prévoit de traiter cette préférence comme un refus de Google-Extended.
Cette condition compte. Le futur signal général n'effacerait pas nécessairement les choix propres à chaque fournisseur. Google explique que ces contrôles spécifiques continueraient à fonctionner, afin qu'un éditeur puisse exprimer une préférence large puis la préciser.
L'annonce mentionne les discussions de normalisation en cours à l'IETF et la recherche d'un mécanisme commun. Elle ne démontre pas que tous les fournisseurs respecteront le même signal, ni que les détails techniques ne changeront pas d'ici 2027.
La décision raisonnable aujourd'hui consiste à noter ce qui est confirmé et ce qui reste à vérifier. Ne copie pas une syntaxe future comme si elle était déjà un standard opérationnel. Prépare plutôt un registre : date de l'annonce, préférence souhaitée, responsable du site et date de réexamen.
Une bonne décision technique peut commencer par ne rien déployer. Ce n'est pas de l'immobilisme si tu as documenté pourquoi tu attends une information fiable.
La méthode P.A.G.E. pour décider
Voici une grille pédagogique originale. Elle n'est ni un score scientifique, ni un audit SEO automatique, ni une certification.
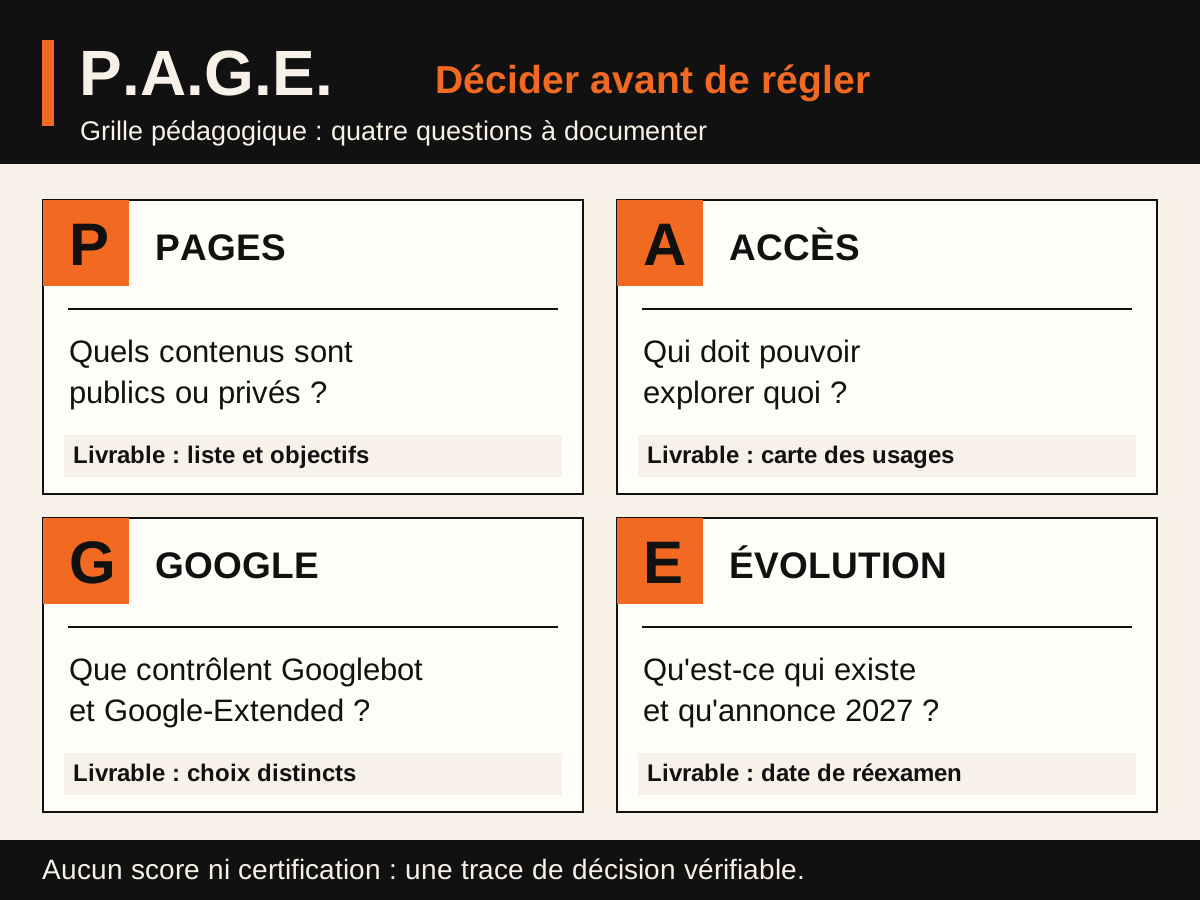
| Étape | Question | Livrable |
|---|---|---|
| P : Pages | Quels contenus sont publics ou privés ? | Liste de pages et objectifs |
| A : Accès | Qui doit pouvoir explorer quoi ? | Carte des usages |
| G : Google | Que contrôlent Googlebot et Google-Extended ? | Décisions distinctes |
| E : Évolution | Qu'est-ce qui existe et qu'est-ce qui est annoncé ? | Date de réexamen |
P : cinq pages représentatives
Choisis l'accueil, un article, une page de service, un portfolio et un document réservé. Note pour chacune si elle doit être découverte publiquement. Si elle contient des données privées, le problème est celui des autorisations d'accès, pas uniquement des robots.
A : sépare les colonnes
Crée une colonne pour l'exploration destinée à la recherche et une autre pour les usages IA. Ajoute une colonne « confidentialité » si nécessaire. Évite un statut unique « robot autorisé » qui masque plusieurs décisions.
G : lis les définitions
Pour Google, consulte les descriptions officielles des jetons. N'attribue pas à un autre fournisseur le comportement promis par Google. Note ce que tu sais et ce que tu ne sais pas.
E : fixe une révision
Écris : « Proposition Google du 30 octobre 2026 ; objectif 2027 ; révision lors d'une nouvelle documentation officielle. » Une date transforme une intention vague en tâche vérifiable.
Trois décisions possibles, sans réponse universelle
Attendre en documentant. Si tu ne connais pas les règles existantes, tu peux choisir de ne rien modifier et de surveiller la normalisation. C'est préférable à un copier-coller non compris.
Étudier un contrôle existant. Google-Extended mérite une analyse si tu souhaites limiter certains usages de contenus. Il faut comprendre ses effets documentés, les conséquences possibles pour Gemini et les besoins du propriétaire du site.
Clarifier ta politique éditoriale. Certains contenus sont faits pour être découverts, d'autres pour rester réservés. Cette distinction peut conduire à améliorer les accès, les droits de réutilisation ou les processus de validation, indépendamment de robots.txt.
| Situation | Réflexe prudent | Erreur à éviter |
|---|---|---|
| Site vitrine récent | Identifier les pages importantes | Bloquer tous les robots |
| Blog original | Comparer Search et usages IA | Promettre un contrôle absolu |
| Espace client | Vérifier l'authentification | Cacher les fichiers par robots.txt |
| Site d'un client | Obtenir un accord écrit | Déployer sans mandat |
Ce tableau sert à structurer une discussion. Il ne remplace ni un audit de configuration ni une analyse juridique.
Cas pratique fictif : une indépendante qui vend des audits
Lina, personnage fictif, propose des audits de présence en ligne à des commerces. Son site contient des guides gratuits, une page de service et des rapports réservés à ses clients. En lisant l'annonce, elle pense devoir bloquer « tous les robots IA ».
Elle commence plutôt par cinq URL. Les guides doivent aider des lecteurs à découvrir son activité. La page de service présente son offre. Les rapports clients exigent de véritables contrôles d'accès, même si les robots les ignorent.
Lina applique P.A.G.E. Elle comprend que « être visible dans Search » et « autoriser l'entraînement » ne sont pas la même question. Elle note aussi que le contrôle commun annoncé pour 2027 n'est pas une commande universelle à activer aujourd'hui.
Son livrable tient sur une page : objectifs, réglages à vérifier, risques connus, responsable de la décision et date de contrôle. Aucun fichier technique n'est modifié. Elle peut alors consacrer son énergie à valider la demande pour son service.
Cet exemple n'est pas un témoignage réel. Il ne prouve aucun gain de trafic, aucune protection juridique et aucun résultat commercial.
Pourquoi ça marche : tu sépares les décisions des réglages
P.A.G.E. fonctionne comme outil d'organisation. Il t'oblige à formuler un objectif avant de choisir une commande. Une personne qui veut être visible dans la recherche n'a pas nécessairement le même besoin qu'une personne qui souhaite limiter l'utilisation de ses contenus pour certains modèles.
La méthode clarifie aussi le vocabulaire. Exploration, indexation, entraînement, grounding et confidentialité décrivent des opérations différentes. Les réunir dans une case « IA » rend une décision facile à annoncer, mais difficile à vérifier.
Enfin, le tableau crée une trace partageable. Un freelance peut expliquer son raisonnement à un client sans lui demander de croire à une promesse. Le propriétaire peut valider ou refuser une recommandation en comprenant ses limites.
La documentation officielle reste la référence. Les annonces promotionnelles et les captures de configurations trouvées en ligne ne suffisent pas à démontrer le comportement d'un robot. Cette prudence évite de transformer un petit chantier SEO en incident de visibilité.
Comment l'appliquer dès aujourd'hui en 40 minutes
Cet exercice est indicatif. Il ne demande aucun accès administrateur et ne garantit aucun résultat SEO.
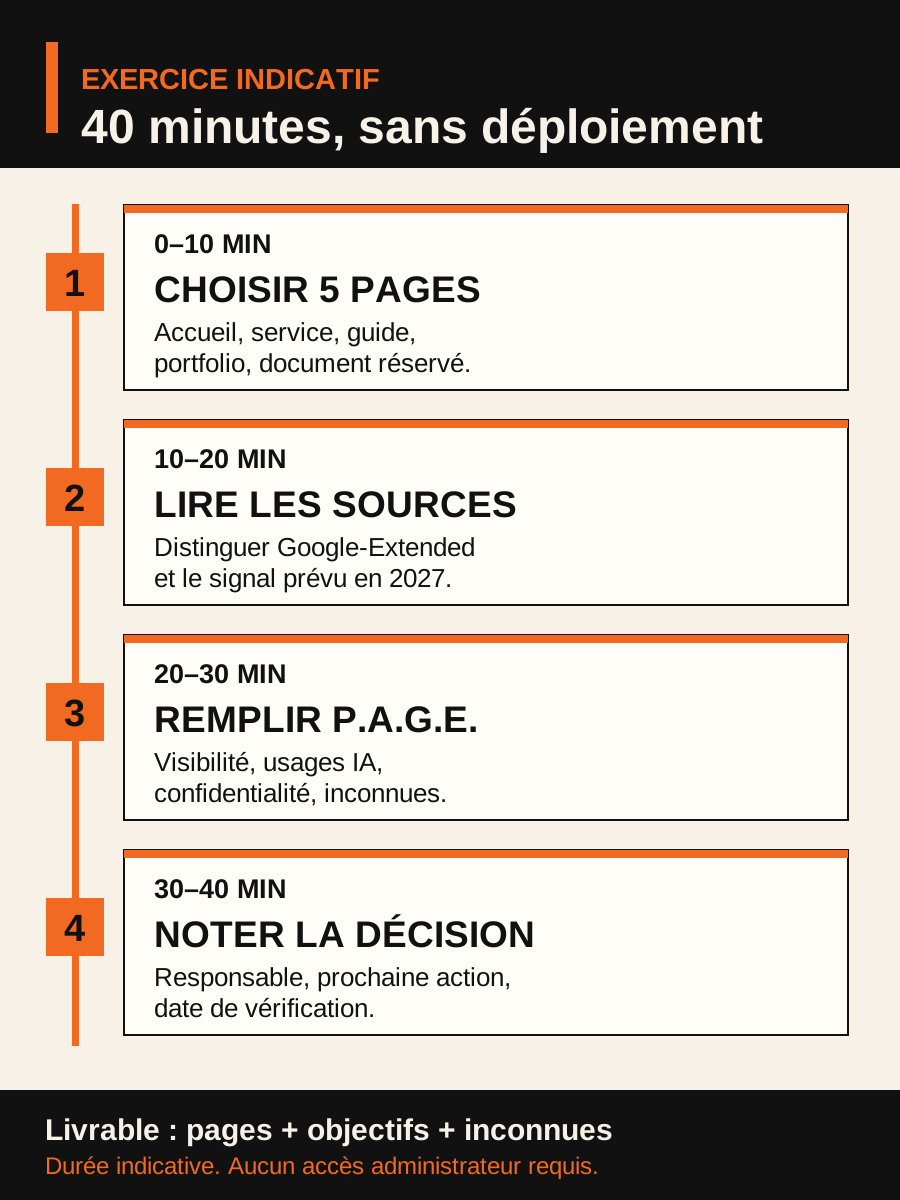
Minutes 0 à 10 : sélectionne cinq pages et note leur fonction. L'accueil présente l'activité ; une page de service peut recevoir des demandes ; un guide répond à une question ; un document privé doit rester protégé. Si tu ignores ton public, commence par choisir une niche de marché.
Minutes 10 à 20 : lis les trois sources officielles. Note deux faits : Google-Extended existe déjà ; le signal commun annoncé le 30 octobre vise 2027. Ajoute une limite : Google-Extended ne modifie pas l'inclusion dans Search, mais concerne certains usages Gemini.
Minutes 20 à 30 : remplis P.A.G.E. Pour chaque URL, demande : visibilité souhaitée dans Search ? Réutilisation IA à discuter ? Données privées ? Une case « inconnu » est une bonne réponse si elle évite une supposition.
Minutes 30 à 40 : rédige une décision provisoire. Exemple : « Aucun changement cette semaine. Nous vérifierons le robots.txt actuel avec le responsable du site et réexaminerons les annonces officielles. »
Tu termines avec un livrable : liste de pages, objectifs, inconnues, responsable et prochaine action. Si tu envisages une veille automatisée, commence par identifier les tâches répétitives à automatiser plutôt que de connecter des outils sans besoin défini.
Erreurs courantes à éviter
1. Dire que le nouveau contrôle est déjà actif partout. Google vise 2027. Une intention ne vaut pas adoption universelle.
2. Confondre Googlebot et Google-Extended. Leurs rôles documentés diffèrent. Vérifie les effets précis.
3. Utiliser robots.txt pour cacher des secrets. Les documents privés exigent une protection d'accès.
4. Copier une règle sans comprendre le site. Une directive peut interagir avec d'autres règles et avec la configuration du serveur.
5. Promettre une présence dans les réponses IA. Un réglage ne garantit ni citation, ni trafic, ni client.
6. Supposer que tous les robots respectent les mêmes préférences. L'adoption dépend des fournisseurs.
7. Changer le site d'un client sans accord. Prévois une autorisation, une sauvegarde et une procédure de retour arrière.
8. Oublier de revenir sur la décision. Une proposition technique peut évoluer. Note une date de vérification.
Ces erreurs sont évitables sans déployer un seul outil supplémentaire. La compétence principale consiste à savoir ce que l'on peut réellement affirmer.
En faire une mission SEO honnête
Cette actualité peut inspirer une petite prestation de diagnostic, pas une promesse de protection totale contre les IA. L'offre pourrait comprendre la cartographie de quelques pages, une lecture des contrôles existants et une note expliquant les choix possibles.
Délimite précisément le travail : un domaine, des pages représentatives, une restitution écrite. Exclue l'implémentation technique, le conseil juridique et la surveillance continue tant qu'ils ne sont pas prévus. Pour fixer un prix, calcule ton temps avec le guide sur le tarif d'une prestation.
Avant de vendre, parle à des personnes concernées. Ont-elles vraiment cette question ? Ont-elles un site qu'elles administrent ? Cherchent-elles une explication ou une intervention ? Les premiers clients freelance se trouvent en vérifiant un besoin, pas en créant une urgence artificielle.
Tu peux proposer un entretien de cadrage sans accès au site. Si aucun besoin concret n'apparaît, n'insiste pas. Une mission utile commence par un problème exprimé et une action vérifiable.
FAQ : robots.txt, IA et référencement
Le contrôle commun d'entraînement IA est-il déjà opérationnel ?
Google a annoncé le 30 octobre 2026 une prise en charge visée en 2027. Il ne faut pas présenter ce mécanisme comme universellement opérationnel en novembre 2026.
Bloquer Google-Extended retire-t-il un site de Google Search ?
Selon Google, Google-Extended n'affecte pas l'inclusion dans Search et n'est pas un signal de classement. Il concerne certains usages des contenus dans des services Gemini.
Robots.txt protège-t-il un document confidentiel ?
Non. Il donne des consignes d'exploration aux robots coopératifs. Un document privé doit être protégé par des contrôles d'accès appropriés.
Faut-il modifier robots.txt immédiatement ?
Pas forcément. Commence par vérifier la configuration actuelle, tes objectifs et les contrôles réellement pris en charge. N'applique pas une syntaxe future comme si elle était standardisée.
Peut-on vendre un audit de ces réglages ?
Oui, si tu sais effectuer les vérifications promises et expliquer leurs limites. Ne garantis ni protection universelle contre l'entraînement IA, ni progression SEO.
Conclusion : documenter avant de bloquer
L'annonce du 30 octobre mérite une veille, pas une réaction précipitée. Le signal commun envisagé pour 2027, Google-Extended et Googlebot ne répondent pas exactement aux mêmes questions. Commence par clarifier les usages souhaités, puis vérifie les contrôles disponibles.
Prends cinq pages, remplis P.A.G.E. et choisis une prochaine action réalisable. Pour transformer cette réflexion en projet concret, découvre les missions guidées de DO TO DAY et avance étape par étape, sans confondre nouveauté technique et preuve de besoin.
Ressources complémentaires
- Annonce Google du 30 octobre 2026 : proposition, calendrier et articulation des contrôles.
- Liste officielle des robots Google : rôle de Google-Extended.
- Interprétation de robots.txt par Google : syntaxe, portée et limites.
Sources et limites
Signal commun annoncé pour 2027, non présenté comme universellement actif en novembre 2026. Aucun changement technique ni conseil juridique individualisé ; aucune garantie de classement, de protection absolue ou de respect par tous les robots.
- Google Search Central — Supporting a shared AI training control for websites (30 octobre 2026)
- Google Crawling Infrastructure — Google's common crawlers et Google-Extended
- Google Crawling Infrastructure — How Google interprets robots.txt
Passer à l’action
Transforme ta lecture en prochaine étape.
La mission Service de DO TO DAY t’aide à définir une offre claire, fixer ton prix et trouver tes premiers clients.
Commencer gratuitementBêta gratuite. Les résultats dépendent du projet et de son exécution.