SEO et IA
Robots.txt et IA : décider quoi protéger avant 2027
Publié le
Google annonce un signal commun de préférence d'entraînement des IA pour 2027. Avant de modifier ton site, voici comment décider ce que tu veux rendre visible et ce que tu dois protéger.
Ce qui a vraiment été annoncé
Le 30 octobre 2026, Google a annoncé son intention de prendre en charge en 2027 un signal partagé dans robots.txt pour exprimer des préférences concernant l'entraînement des modèles d'intelligence artificielle. C'est une annonce de projet, pas une fonctionnalité universellement opérationnelle aujourd'hui. L'heure de publication de l'annonce n'est pas fournie sur la page officielle. Ce détail compte : une date précise ne transforme pas une proposition en règle déjà appliquée.
Le mécanisme évoqué s'appuie sur les travaux du groupe AIPREF de l'IETF. L'idée est qu'un éditeur puisse déclarer une préférence générale, au lieu de gérer uniquement une série de directives propres à chaque fournisseur. Google indique que ses contrôles particuliers, notamment Google-Extended, continueraient d'exister en parallèle. La manière dont les autres fournisseurs interpréteront le signal dépendra de leur adoption réelle. Tu ne peux donc pas supposer qu'un seul réglage protégera instantanément tous tes textes, toutes tes images et toutes tes données.
Pour une petite entreprise, la bonne nouvelle n'est pas un bouton magique. C'est une occasion de clarifier la valeur de ses contenus : qu'est-ce qui doit rester accessible aux prospects, qu'est-ce qui relève d'une expertise originale, et quelles décisions nécessitent un avis technique ou juridique ? La réponse commence par un inventaire, pas par une modification précipitée.
Pourquoi une TPE doit distinguer trois questions
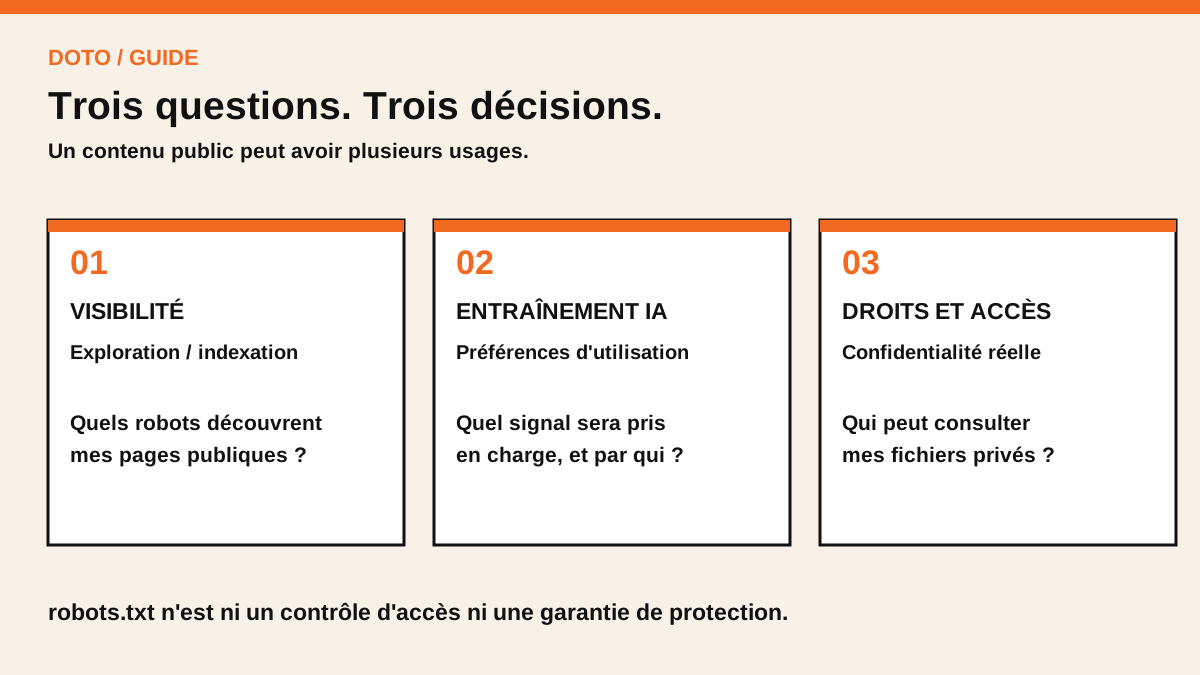
Imagine que tu proposes des services de création de sites. Ton blog attire des prospects grâce à des guides gratuits. Tu publies aussi des modèles de devis et des méthodes issues de missions clients. Ces contenus n'ont pas tous la même fonction. Certains doivent être faciles à découvrir ; d'autres contiennent un savoir-faire différenciant ; d'autres encore ne devraient jamais être publics.
Il faut séparer exploration et indexation, utilisation éventuelle pour l'entraînement et droits sur les contenus. Un fichier robots.txt sert historiquement à communiquer des instructions aux robots qui choisissent de les respecter. Il n'est ni un système d'authentification ni une serrure empêchant le téléchargement. Une préférence d'entraînement n'est pas non plus une garantie juridique automatique ni un moyen de supprimer des copies déjà réalisées.
Cette séparation évite deux erreurs opposées. La première consiste à bloquer trop largement et à découvrir ensuite que des pages utiles deviennent moins accessibles à certains robots. La seconde consiste à ne rien documenter et à confondre une page librement consultable avec un contenu sans droits. Le choix doit correspondre à ton modèle économique, à tes objectifs de visibilité et aux moyens réels dont tu disposes pour le contrôler.
La méthode TRACE : cinq décisions sans toucher au site
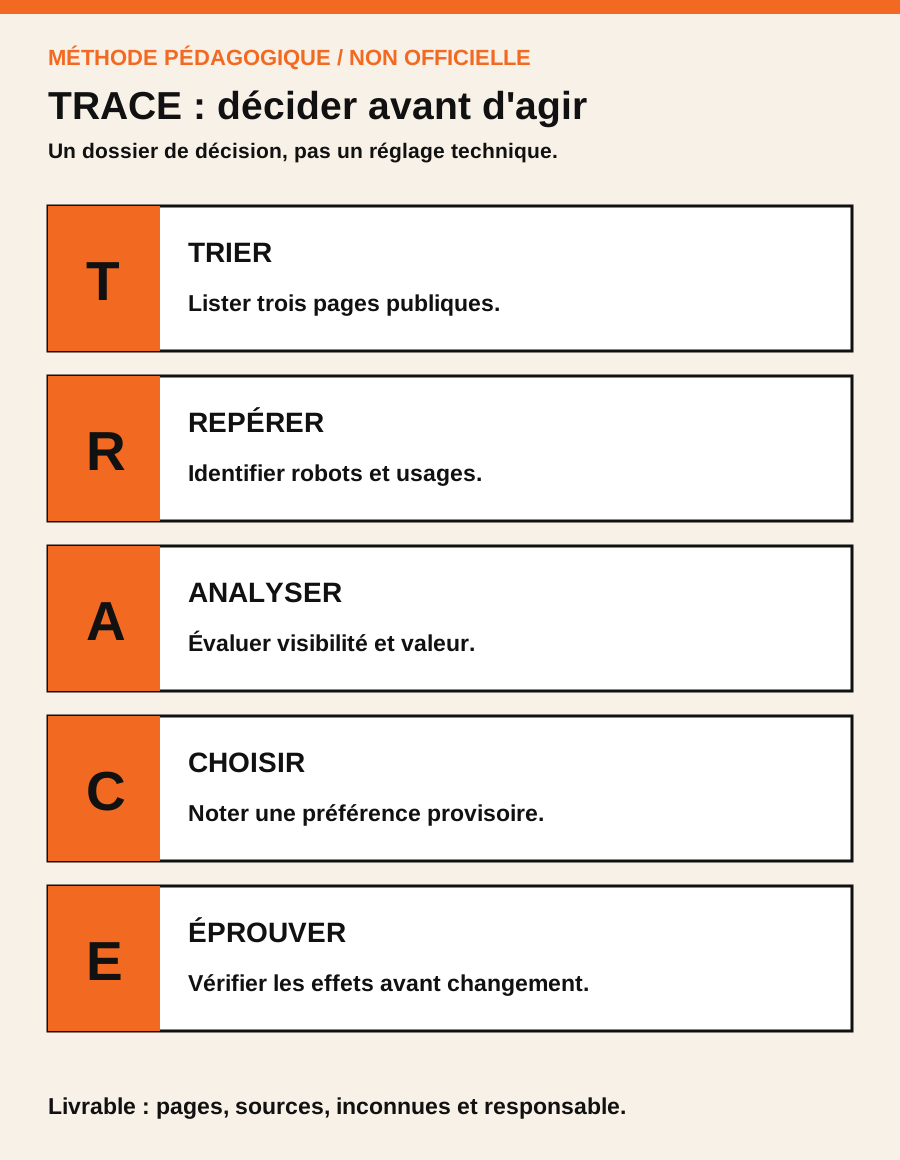
Pour ne pas te perdre dans les détails techniques, utilise la méthode pédagogique TRACE. Elle ne représente pas un standard officiel. Elle sert à construire un dossier de décision que tu pourras relire avec ton développeur ou ton hébergeur. T pour trier les contenus, R pour repérer les robots et usages, A pour analyser la valeur, C pour choisir une préférence, E pour éprouver les conséquences.
Commence par trois pages, pas par tout ton domaine. Prends une page de présentation, un guide pratique et une ressource originale. Pour chacune, note le public visé, la raison de sa publication, l'intérêt de son référencement et les informations qu'elle révèle. Si une page contient des données confidentielles, la question n'est plus le réglage de robots.txt : il faut examiner pourquoi elle est accessible publiquement.
Le résultat attendu est une feuille de travail d'une page. Elle doit indiquer ce qui est connu, ce qui reste hypothétique et la personne capable de valider la prochaine action. Cette discipline semble modeste, mais elle évite de traiter un sujet stratégique comme une simple case à cocher dans une interface.
Un tableau pour classer tes contenus
Voici un exemple entièrement fictif pour un indépendant qui vend des prestations numériques. Les décisions proposées ne sont pas des recommandations universelles : elles montrent comment documenter les arbitrages avant de toucher à la configuration.
| Contenu fictif | Objectif principal | Question à vérifier | Décision provisoire |
|---|---|---|---|
| Page de service | Être découvert par des clients | Le référencement est-il prioritaire ? | Préserver l'accès utile aux moteurs |
| Guide gratuit | Démontrer une expertise | Quelle réutilisation est acceptable ? | Documenter la préférence souhaitée |
| Modèle de méthode original | Différencier l'offre | Quels droits et usages sont en jeu ? | Demander une revue avant changement |
| Document client | Exécuter une mission privée | Pourquoi serait-il public ? | Contrôler les accès, pas robots.txt |
Ajoute une colonne « preuve » : capture de la page, source de la règle, date de consultation, responsable de la décision. Si tu travailles seul, tu es ce responsable. Si un client te confie son site, ne change jamais sa politique de robots sans autorisation explicite. Une instruction technique peut modifier la visibilité ou les usages possibles du contenu ; elle mérite une décision traçable.
Ce tableau te permet aussi de relier l'audit à une offre de service concrète. Tu peux proposer un diagnostic documenté, mais pas vendre une garantie d'invisibilité aux systèmes d'IA. Pour apprendre à cadrer une prestation, commence par calculer le prix d'un service et définir exactement ce qui est inclus.
Ce que robots.txt ne peut pas promettre
Une préférence exprimée dans un fichier public dépend du comportement de l'acteur qui la lit. Elle n'empêche pas matériellement un acteur de consulter une URL. Elle ne retire pas des données déjà diffusées. Elle ne transforme pas un contenu public en coffre-fort. Et elle ne remplace pas un contrôle d'accès pour des espaces réservés, des fichiers privés ou des informations personnelles.
L'annonce de Google décrit une prise en charge envisagée en 2027 et des règles d'interprétation annoncées pour ses propres systèmes. Elle ne permet pas de conclure que tous les fournisseurs d'IA se sont engagés à appliquer la même politique dès aujourd'hui. Elle ne permet pas non plus d'affirmer que chaque cas de présence dans une réponse générée par IA est équivalent à de l'entraînement.
Autre point important : Google distingue ses contrôles existants et le futur signal partagé. Si tu as déjà une configuration particulière, ne la remplace pas par une syntaxe lue sur un réseau social. Conserve une copie du fichier actuel, relève la date, identifie les lignes que tu comprends et fais vérifier les autres. La bonne séquence est documentation, décision, test, puis éventuellement modification par la personne autorisée.
Pourquoi ça marche : une décision avant une configuration
La méthode TRACE fonctionne comme un filtre contre la précipitation. Elle transforme une annonce technique en questions que tu peux réellement résoudre. Une petite entreprise ne dispose pas toujours d'un responsable SEO, d'un juriste et d'un administrateur système. Pourtant, elle peut établir un inventaire fiable, distinguer les usages et choisir ce qui mérite une vérification spécialisée.
Tu réduis aussi le risque de confondre l'objectif et le moyen. L'objectif peut être d'attirer des clients grâce à un contenu utile. Le moyen n'est pas nécessairement de modifier un fichier. Il peut être de mieux présenter l'offre, de publier un exemple original ou de clarifier une page existante. Google rappelle par ailleurs, dans ses recommandations sur la recherche générative, l'importance d'un contenu unique et réellement utile. Il n'annonce pas de raccourci permettant de garantir une citation ou une position.
Un diagnostic utile produit donc deux résultats distincts : une politique de contenus compréhensible et une liste de modifications éventuelles à évaluer. Si la seconde liste est vide, ce n'est pas un échec. Cela signifie que tu as choisi de ne pas agir sans preuve suffisante.
Cas pratique fictif : une agence de services locale
Prenons Lina, personnage fictif qui crée des sites vitrines pour des commerces. Son site comprend une page d'accueil, trois études de cas autorisées et une bibliothèque de conseils. Elle entend parler du futur signal partagé et envisage de bloquer immédiatement tous les robots. Elle pense ainsi protéger son travail sans conséquence commerciale.
Avant d'agir, Lina ouvre son tableau TRACE. Sa page de service doit permettre à des prospects de comprendre ce qu'elle vend. Ses études de cas ne contiennent que des informations dont la publication a été autorisée. Ses modèles internes de diagnostic, eux, ne sont pas publics. Le problème prioritaire n'est donc pas de « cacher tout le site » : c'est de vérifier que les ressources privées restent privées et de décider quelle préférence exprimer sur les ressources publiques.
Elle consacre une séance fictive de quarante minutes à relever les pages, puis note trois questions pour son prestataire technique : quels contrôles existent déjà, quels effets une modification pourrait-elle avoir et comment vérifier le résultat ? Elle ne promet aucun gain de trafic ni aucune protection absolue. Elle garde une trace écrite de son choix. Pour compléter sa démarche commerciale, elle peut choisir une niche précise plutôt que transformer un réglage technique en argument de vente spectaculaire.
Comment l'appliquer dès aujourd'hui en 45 minutes
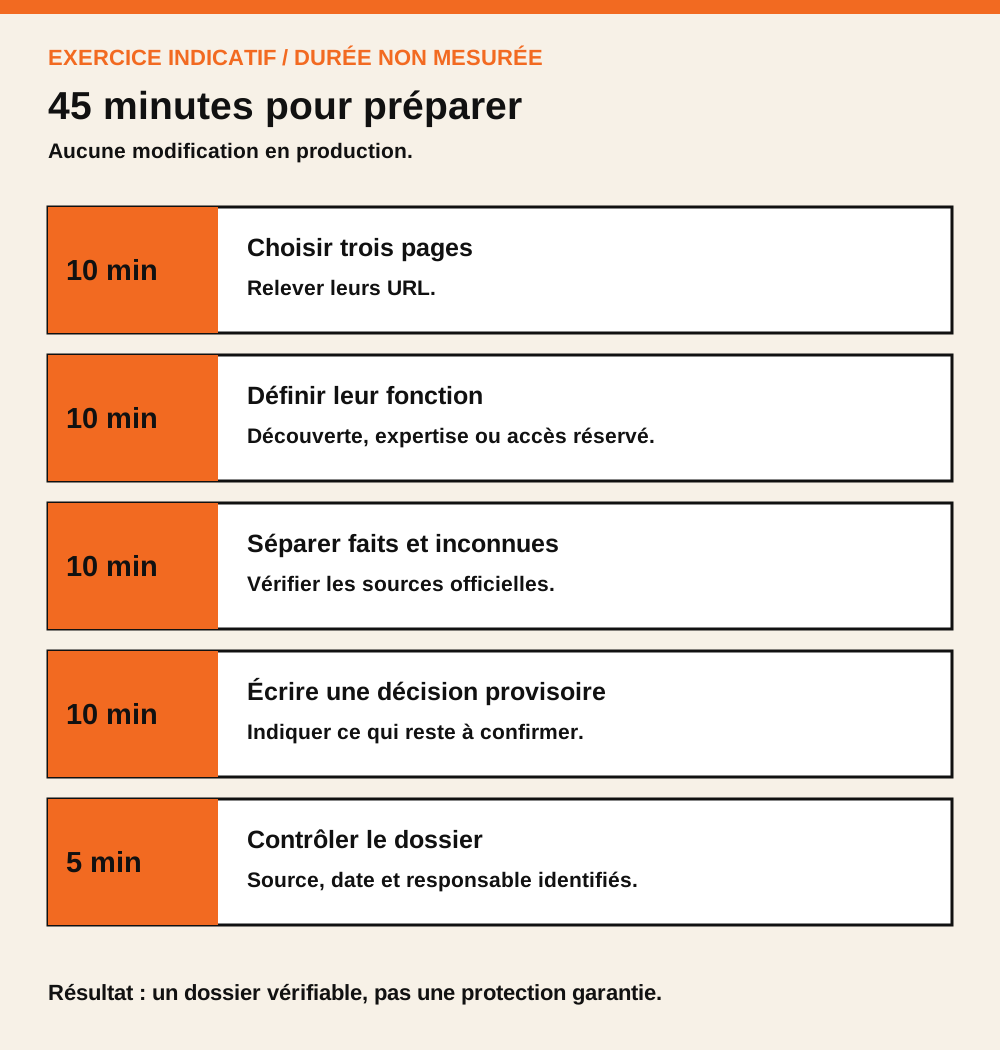
L'exercice suivant est une proposition d'organisation, pas une durée moyenne mesurée. Prévois dix minutes pour sélectionner trois pages et relever leurs URL. Pendant les dix minutes suivantes, écris leur fonction : découverte, démonstration, ressource réservée ou autre. Consacre ensuite dix minutes à distinguer ce que tu sais des préférences d'entraînement et ce que tu ignores encore.
Utilise les dix minutes suivantes pour écrire ta décision provisoire. Par exemple : « Je souhaite maintenir la découvrabilité de mes pages de service et examiner les options de préférence d'entraînement quand elles seront documentées et prises en charge. » Termine par cinq minutes de vérification : as-tu noté une source officielle, la date de consultation et une personne responsable de toute modification ?
Si tu ne gères pas toi-même le serveur, le livrable n'est pas un nouveau robots.txt. C'est un message clair au prestataire avec les pages concernées, les objectifs et les questions ouvertes. Si tu gères le site, n'applique rien sur la production avant de connaître la syntaxe officiellement prise en charge et d'avoir une sauvegarde. Cette approche laisse de la place à l'action sans confondre vitesse et maîtrise.
Erreurs courantes à éviter
Première erreur : annoncer que le nouveau signal est déjà universellement disponible. Google parle d'une prise en charge visée pour 2027. La date de l'annonce est le 30 octobre 2026 ; ce n'est pas une date d'entrée en vigueur générale. Deuxième erreur : croire qu'une directive robots.txt constitue une protection technique contre l'accès à des données privées. Pour cela, il faut des mécanismes d'accès adaptés.
Troisième erreur : confondre entraînement, exploration, indexation et citation dans des réponses. Ces usages peuvent relever de mécanismes distincts. Quatrième erreur : recopier une configuration non vérifiée, sans connaître les conséquences sur le site. Cinquième erreur : promettre à un client qu'une modification suffira à empêcher toute utilisation future de son contenu. Une telle garantie n'est pas démontrée.
Sixième erreur : oublier le métier. Une entreprise a besoin de prospects, de pages claires et de preuves de son expertise. Un audit de robots.txt ne remplace pas une offre lisible. Si tu n'as pas encore validé ton positionnement, valide d'abord ton idée et travaille une page qui explique ton offre. L'annonce technique ne doit pas devenir une distraction permanente.
Transformer le sujet en mission utile
Tu peux exploiter ce sujet de deux façons, selon ton activité. Si tu possèdes un site, réalise ton propre diagnostic et conserve un historique des décisions. Si tu vends des prestations numériques, propose une offre limitée : inventaire de pages publiques, relevé des contrôles existants, synthèse des risques et recommandations à valider. Ne vends pas une conformité juridique ni une promesse de classement.
Une offre pilote pourrait prévoir une réunion de cadrage, une liste des pages examinées et un document de décision. Le client décide ensuite s'il souhaite une intervention technique séparée. Pour construire cette offre, appuie-toi sur les premiers clients freelance et sur une estimation honnête du temps nécessaire. Chaque livrable doit pouvoir être montré sans exposer des données confidentielles.
Dans DOTO, l'approche correspond à une logique simple : choisir une mission, comprendre le problème et avancer par étapes. Tu peux utiliser une feuille de travail en parallèle, même sans outil payant. L'essentiel est de distinguer une tâche terminée d'une hypothèse encore ouverte. Une politique claire vaut mieux qu'un réglage spectaculaire que personne ne sait expliquer.
FAQ : les réponses courtes
Le nouveau contrôle IA est-il déjà actif partout ?
Non. Le 30 octobre 2026, Google a annoncé un projet de prise en charge pour 2027. L'adoption par les fournisseurs et les détails opérationnels doivent être vérifiés au moment de l'application.
Robots.txt empêche-t-il de copier une page ?
Non. C'est un fichier d'instructions destiné aux robots qui choisissent de les respecter, pas un système d'authentification ni une barrière contre le téléchargement.
Dois-je bloquer Google pour protéger mes contenus ?
Pas automatiquement. Commence par distinguer visibilité dans la recherche, entraînement des modèles et confidentialité. Une décision générale peut avoir des conséquences indésirables.
Peut-on faire cet audit sans coder ?
Oui, l'inventaire et la politique de contenus peuvent être préparés sans code. Toute modification technique doit ensuite être contrôlée et autorisée.
Est-ce une nouvelle méthode pour améliorer son classement ?
Non. L'annonce concerne des préférences d'utilisation des contenus pour l'entraînement. Elle ne promet aucune hausse de visibilité dans les résultats de recherche.
Ressources complémentaires et prochaine étape
Pour comprendre précisément l'annonce, consulte la publication officielle du 30 octobre 2026. Pour distinguer les bonnes pratiques de visibilité des mythes autour de la recherche générative, lis les recommandations Google de mai 2026. Enfin, pour mieux comprendre les limites historiques des instructions aux robots, utilise la documentation Google sur robots.txt.
Ces ressources ne remplacent pas un avis juridique adapté à ton cas. Elles permettent de vérifier les termes techniques et de ne pas confondre projet, recommandation et obligation. Si une directive est encore en discussion, note-la comme telle dans ton dossier. Ne l'ajoute pas à ton site simplement parce qu'un exemple circule.
Ta prochaine étape tient en une phrase : choisis trois pages, écris pourquoi elles existent et décide ce qui mérite une vérification. Ensuite seulement, prépare une éventuelle intervention. Si tu veux structurer ce travail parmi d'autres actions de lancement, explore DO TO DAY et choisis une mission qui correspond à ton activité. Aucun outil ne remplace le jugement sur ce que tu souhaites rendre public.
Sources et limites
Signal annoncé pour 2027, non présenté comme opérationnel universellement ; exemples fictifs ; aucune garantie de protection, de référencement ou de conformité juridique.
- Google Search Central — Supporting a shared AI training control for websites
- Google Search Central — A new resource for optimizing for generative AI in Google Search
- Google Search Central — Introduction to robots.txt
Passer à l’action
Transforme ta lecture en prochaine étape.
Choisis une mission, suis les étapes une par une et garde ta progression au même endroit avec DO TO DAY.
Commencer gratuitementBêta gratuite. Les résultats dépendent du projet et de son exécution.