SEO · Contrôles IA
Robots.txt et entraînement IA : décider sans bloquer son SEO
Publié le
Google prépare un signal partagé pour exprimer les préférences d'entraînement IA. Avant de toucher à robots.txt, clarifie ce que tu veux rendre visible, protéger ou encadrer.
Ce que Google a réellement annoncé
Le 30 octobre 2026, Google a annoncé son intention de prendre en charge un contrôle partagé des préférences d'entraînement des modèles d'intelligence artificielle dans robots.txt. Le projet s'appuie sur le travail du groupe AIPREF de l'IETF. Google vise une prise en charge en 2027, avec d'autres fournisseurs. C'est donc une annonce de projet, pas une fonction universelle déjà déployée. L'heure exacte de publication n'est pas indiquée dans la source officielle.
Le principe annoncé consiste à employer un jeton de politique commun pour exprimer une préférence à plusieurs fournisseurs participants. Google prévoit que, lorsqu'un site exprime une opposition à l'entraînement avec ce signal sans préciser explicitement Google-Extended, cette opposition soit interprétée comme un refus pour Google-Extended. Les contrôles propres à chaque fournisseur continueraient de fonctionner en parallèle. Il ne faut pas en déduire que tous les robots du monde respecteront immédiatement la même règle.
Cette nuance est importante pour une petite entreprise. Un titre spectaculaire peut donner envie de modifier son fichier robots.txt dès aujourd'hui. Pourtant, la bonne première action est documentaire : comprendre quels contenus sont concernés, qui peut décider et quelles conséquences sont acceptables. Une règle technique sans objectif commercial ni éditorial clair est une source d'erreurs évitables.
Trois questions différentes à ne pas mélanger
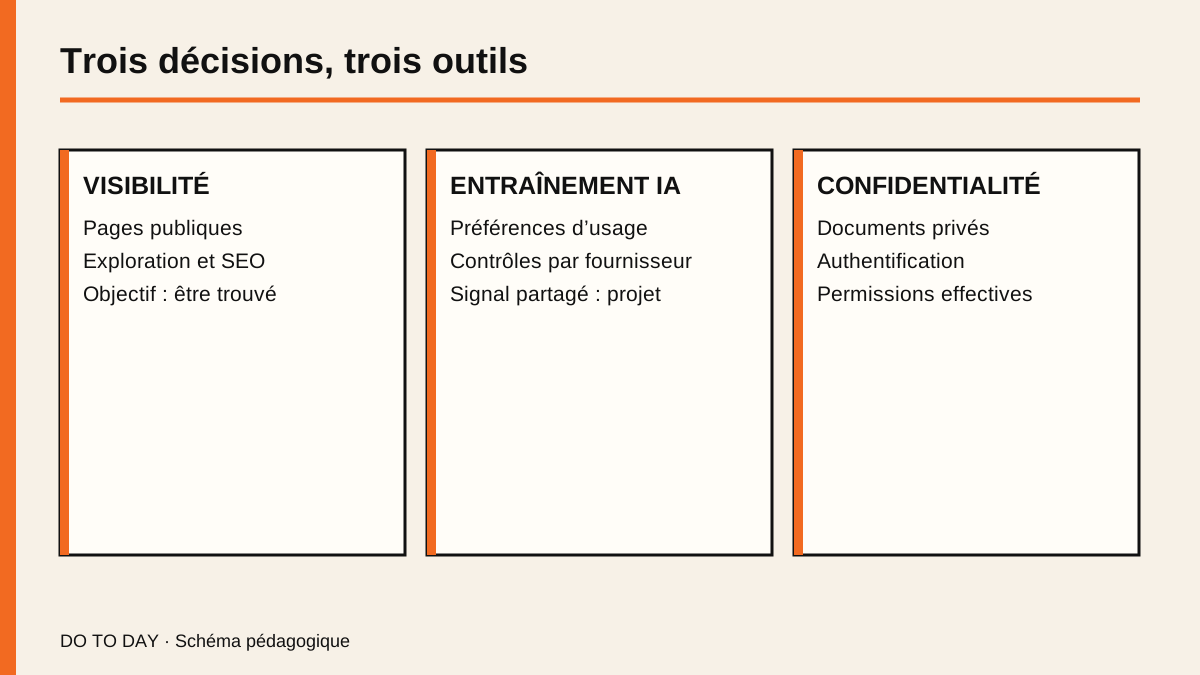
La première question concerne la découverte dans les moteurs de recherche. Tu veux peut-être que tes pages de services, tes fiches produit et tes guides soient explorés et trouvés. Le référencement naturel dépend de plusieurs conditions, dont l'accessibilité, la pertinence et la qualité. Il n'est pas garanti par une directive robots.txt.
La deuxième question concerne l'utilisation de tes contenus pour entraîner des modèles. Elle est distincte de l'affichage d'un lien dans un moteur de recherche. Une entreprise peut souhaiter être trouvée par des prospects tout en exprimant des préférences sur certains usages de ses textes. C'est précisément ce type de distinction que le projet annoncé cherche à rendre plus simple pour les éditeurs.
La troisième question concerne la confidentialité. Un document privé, un devis client ou une fiche comportant des données personnelles ne devient pas secret parce qu'un robot reçoit une consigne. Si une ressource doit être réservée à une personne autorisée, il faut un véritable contrôle d'accès. Les consignes destinées aux robots ne remplacent ni une authentification ni une gestion correcte des permissions.
Ces trois sujets appellent des décisions séparées. Avant toute modification, écris une phrase pour chacun : quelles pages doivent être découvertes, quels usages d'entraînement souhaites-tu encadrer et quelles données ne doivent jamais être accessibles publiquement. Si tu ne sais pas répondre, commence par un inventaire plutôt que par du code.
Le cadre SOURCE pour prendre une décision
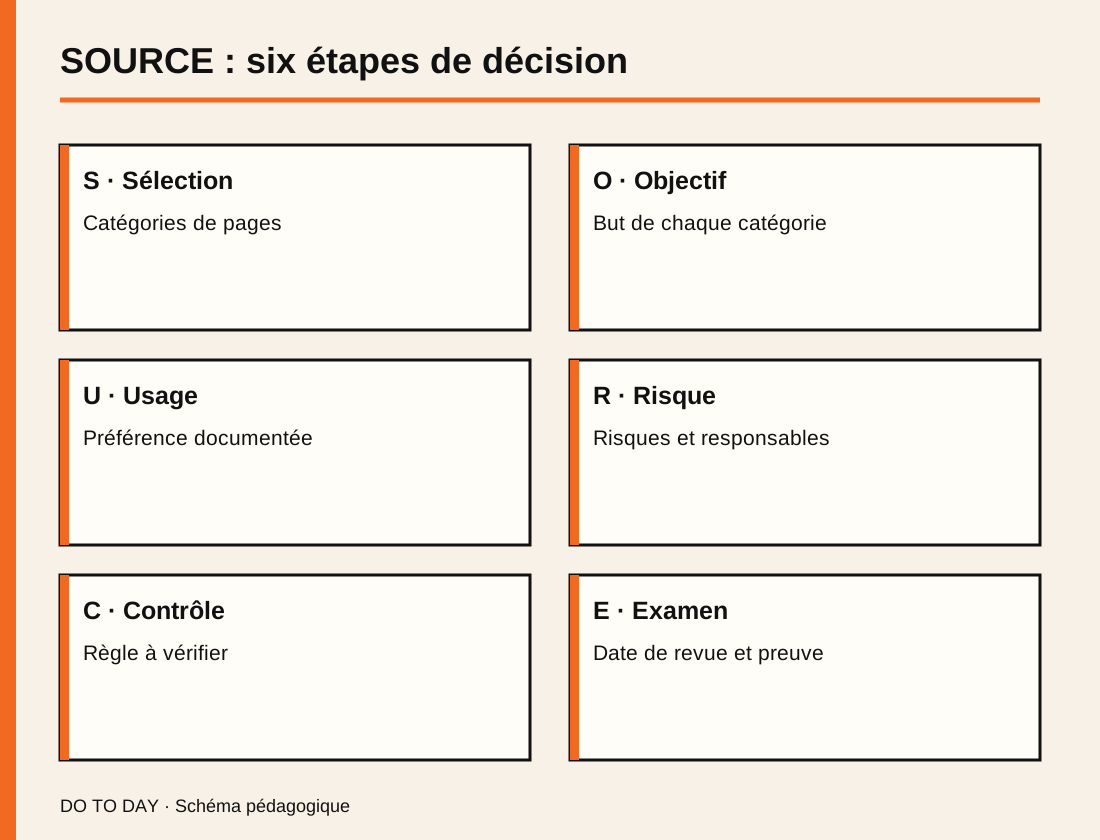
Pour éviter de traiter un sujet complexe en une seule modification précipitée, utilise le cadre SOURCE. Il ne s'agit pas d'un standard technique, mais d'une méthode de travail éditoriale proposée dans ce guide.
| Étape | Question | Livrable |
|---|---|---|
| S, Sélection | Quels contenus possèdes-tu réellement ? | Liste des catégories de pages |
| O, Objectif | Pourquoi ces pages sont-elles publiques ? | But de chaque catégorie |
| U, Usage | Quel usage par les IA veux-tu autoriser ou refuser ? | Préférence documentée |
| R, Risque | Quelles données ou fonctions sont sensibles ? | Risques et responsables |
| C, Contrôle | Quelle règle existante est appropriée ? | Décision technique à vérifier |
| E, Examen | Quand faut-il réévaluer la décision ? | Date de revue et preuve |
S : sélectionner sans tout mélanger
Commence par classer tes contenus : accueil, blog, pages de vente, documentation, outils publics, espace client et fichiers téléchargeables. Ne pars pas du principe que toutes ces catégories doivent suivre la même politique. Une page de présentation publique et un document client n'ont pas le même objectif ni le même niveau de risque.
O : écrire l'objectif de chaque page
Une page qui explique une prestation vise généralement à aider un visiteur à comprendre l'offre. Une documentation technique peut faciliter l'utilisation d'un produit. Un espace client sert à une personne identifiée. Écris le rôle de chaque catégorie avant de parler d'indexation ou d'entraînement. Cela évite de sacrifier la visibilité d'un contenu utile à cause d'une inquiétude mal définie.
U : formuler une préférence explicite
Une préférence n'est pas une garantie universelle d'application. Distingue les fournisseurs qui publient des contrôles précis, les mécanismes annoncés pour l'avenir et les usages pour lesquels tu ne disposes d'aucune preuve. Documente ce que tu souhaites, puis compare avec les spécifications officielles disponibles au moment du changement.
R : identifier les vrais risques
Une politique de robot n'est pas un système de sécurité. Si un fichier contient un contrat, un prix négocié ou des informations nominatives, la question prioritaire est celle de son accès. Demande-toi également qui a le droit de changer la configuration : propriétaire du site, prestataire technique ou responsable éditorial. Une décision non autorisée peut créer davantage de problèmes qu'elle n'en résout.
C et E : contrôler puis réexaminer
Ne copie pas un extrait de configuration trouvé sur un réseau social sans vérifier sa date et sa compatibilité. Note l'état initial, le changement envisagé, la documentation utilisée et le résultat attendu. Prévois ensuite une revue. Un mécanisme annoncé pour 2027 mérite une veille, pas une prétendue installation obligatoire en novembre 2026.
Pourquoi ça marche
Le cadre SOURCE sépare une décision de gestion d'une opération technique. C'est utile parce qu'un même mot, « bloquer », peut désigner des choses très différentes : limiter l'exploration, réduire la présence dans un résultat, exprimer une préférence d'entraînement ou protéger un document. Une mauvaise traduction du besoin conduit facilement à une mauvaise configuration.
La méthode réduit aussi la surcharge. Au lieu de comparer immédiatement des dizaines de robots et de directives, tu commences par trois ou quatre catégories de pages. Tu identifies une seule question non résolue et cherches sa réponse dans la documentation primaire. Le travail devient vérifiable, même si tu n'es pas développeur.
Enfin, conserver un état initial permet de revenir sur une décision. Un fichier robots.txt est court, mais ses effets potentiels sont larges. La prudence ne consiste pas à ne rien faire pour toujours : elle consiste à ne changer que ce que tu comprends, avec une raison précise et un contrôle possible.
Cas pratique fictif : une petite boutique en ligne
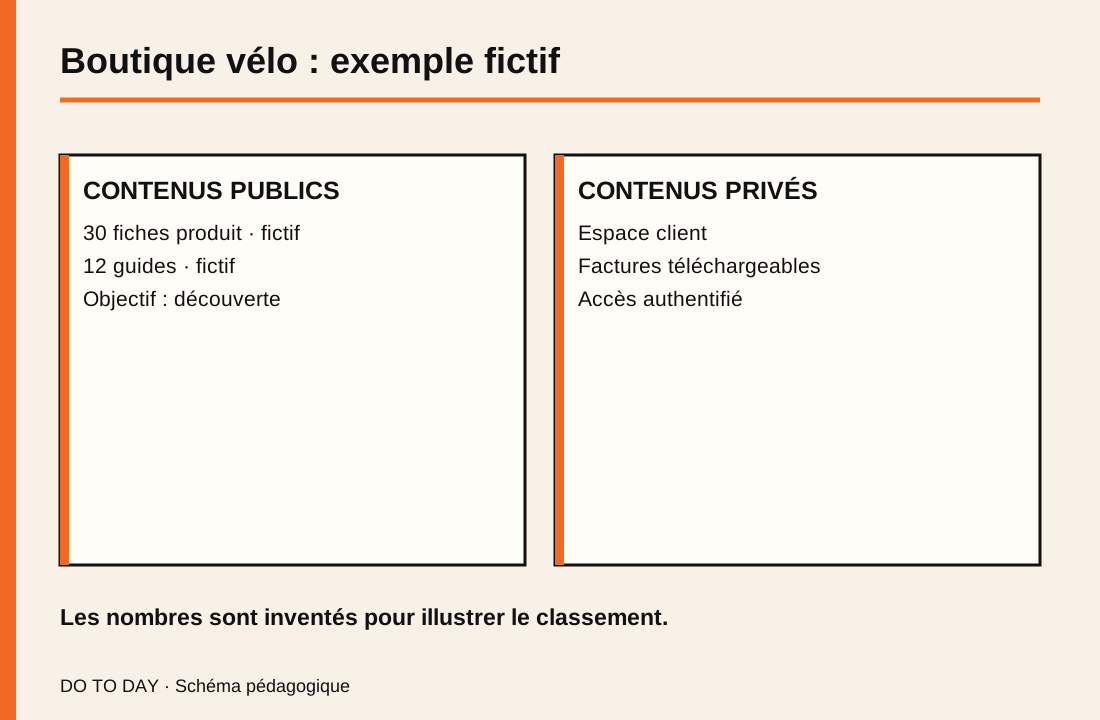
Imagine une boutique fictive qui vend des accessoires pour vélos. Son site contient une page d'accueil, trente fiches produit, douze guides d'entretien, un espace client et des factures téléchargeables. Les nombres sont inventés uniquement pour illustrer le classement des contenus. Ils ne décrivent aucune entreprise réelle.
La propriétaire découvre l'annonce de Google et veut immédiatement interdire tous les robots. Son objectif déclaré est pourtant de permettre aux personnes cherchant des pièces compatibles de découvrir ses fiches. Une interdiction générale de l'exploration pourrait contredire cet objectif. Elle décide donc de ne pas toucher à la configuration avant d'avoir distingué les catégories.
Les fiches produit et les guides sont destinés au public. Leur découverte peut être utile à l'activité, sans garantie de ventes. L'espace client et les factures ne doivent pas être accessibles aux visiteurs anonymes. Leur protection relève d'abord de l'authentification et des autorisations. Quant à l'entraînement des IA, la propriétaire souhaite exprimer une préférence mais ne sait pas encore quels fournisseurs et quels mécanismes sont concernés.
Elle ouvre un document avec quatre colonnes : catégorie, objectif, accès autorisé, décision en attente. Elle consulte ensuite l'annonce officielle du 30 octobre et la documentation actuelle des robots. Son livrable n'est pas une ligne de code improvisée. C'est une politique provisoire compréhensible, prête à être revue avec la personne qui administre le site.
Ce cas ne démontre aucun gain SEO ni aucune réduction mesurée de collecte. Il montre comment passer d'une actualité à une décision raisonnée. Pour compléter la réflexion commerciale, tu peux aussi valider le besoin avant de développer et choisir un modèle économique adapté.
Ce que robots.txt peut faire, et ses limites
Le fichier robots.txt permet de communiquer des instructions d'exploration à des robots qui choisissent de les respecter. Sa syntaxe et ses effets dépendent du mécanisme et du robot concerné. Il ne constitue pas un mot de passe. Une URL peut rester accessible directement même si un robot est invité à ne pas la parcourir.
Une consigne de non-exploration ne doit pas être confondue avec une directive d'absence d'indexation. Pour certains moteurs, empêcher l'exploration peut même empêcher la lecture d'une directive située dans la page. Avant de choisir une technique, consulte les recommandations propres au moteur et au cas d'usage.
La documentation de Google distingue également les contrôles applicables à Search et les mécanismes liés à d'autres produits ou usages. Google-Extended est un contrôle existant ; le jeton partagé annoncé en octobre 2026 est un projet dont la prise en charge est visée pour 2027. Ne présente pas les deux comme une fonction identique déjà active partout.
Si tu travailles pour un client, n'affirme jamais qu'une règle interdit juridiquement toute réutilisation. Une préférence technique, un droit d'auteur, un contrat et une mesure de sécurité sont des sujets distincts. Selon la situation, une analyse juridique peut être nécessaire. Le guide ne remplace pas un avis professionnel sur les droits des contenus.
Comment l'appliquer dès aujourd'hui
Prévois une séance courte, par exemple quarante-cinq minutes à titre indicatif. Le but n'est pas de devenir expert de tous les robots. Le but est de sortir avec une décision documentée et une prochaine étape raisonnable.
Première séquence : choisir une catégorie
Sélectionne une seule catégorie de pages de ton site. Pour un indépendant, il peut s'agir des articles de blog. Pour une boutique, commence éventuellement par les fiches produit. Pour un micro-SaaS, distingue la documentation publique de l'espace connecté. Note deux URL représentatives sans copier de données personnelles dans un outil externe.
Deuxième séquence : lire la source primaire
Lis l'annonce officielle de Google datée du 30 octobre 2026. Relève ce qui existe, ce qui est annoncé et ce qui reste à standardiser. Vérifie ensuite les pages de documentation relatives aux contrôles de l'exploration et aux fonctionnalités IA. Ne transforme pas une intention de prise en charge en obligation immédiate.
Troisième séquence : écrire une fiche de décision
Ta fiche peut tenir sur quelques lignes : « Catégorie : guides publics. Objectif : découverte et aide au lecteur. Préférence d'entraînement : à décider. Données sensibles : aucune attendue, à vérifier. Changement technique : aucun avant validation. Revue : date choisie. » Le contenu de cet exemple est fictif ; adapte-le à tes propres informations.
Quatrième séquence : demander une validation
Si tu ne contrôles pas l'hébergement, transmets la fiche au responsable technique. Si tu le contrôles, conserve une copie de la configuration actuelle avant toute intervention. Dans tous les cas, sépare le diagnostic de la modification. Une décision différée et justifiée vaut mieux qu'un blocage général décidé dans l'urgence.
Tu peux compléter cette démarche avec les bases du SEO pour un blog d'entreprise et un exemple de maillage interne. Ces deux guides abordent la visibilité éditoriale, distincte de la politique d'entraînement des modèles.
Transformer cette compétence en service sans survendre
Un freelance peut proposer une prestation de cadrage plutôt qu'une promesse de protection absolue. Le livrable peut comprendre l'inventaire des catégories de pages, la distinction entre visibilité et confidentialité, un état des contrôles existants, des sources officielles et une liste de décisions à valider. Ce service ne nécessite pas de vendre une automatisation complexe dès le départ.
Pour tester l'intérêt, interroge quelques propriétaires de sites sur leurs préoccupations réelles. Demandent-ils une meilleure compréhension de leurs paramètres ? Ont-ils un prestataire capable d'appliquer une décision ? Craignent-ils surtout l'exposition de documents privés ? Ces réponses permettront de savoir si le besoin porte sur un audit éditorial, une intervention technique ou un conseil juridique à orienter vers un spécialiste.
Évite de vendre un « bouclier anti-IA » ou une garantie de disparition des contenus. Ce serait difficile à justifier. Décris plutôt une prestation limitée : cartographier les contenus, clarifier les préférences, documenter les contrôles et transmettre des recommandations vérifiables. Pour la tarification, appuie-toi sur ton temps réel et sur un périmètre écrit, pas sur un résultat supposé.
Avant de prospecter, consulte le guide pour trouver ses premiers clients sans publicité et le business plan sans chiffres inventés. Ils permettent de relier une compétence technique à un test commercial prudent.
Erreurs courantes
Confondre annonce et déploiement. Google vise 2027 pour la prise en charge du mécanisme partagé. Une publication datée d'octobre 2026 ne signifie pas que chaque fournisseur l'applique déjà.
Bloquer toute l'exploration par réflexe. Une règle générale peut entrer en conflit avec l'objectif de visibilité de tes pages publiques. Commence par préciser le besoin.
Utiliser robots.txt pour protéger un compte. Un document sensible doit être protégé par des permissions effectives. Une consigne aux robots n'empêche pas l'accès direct.
Promettre une protection universelle. Les fournisseurs peuvent suivre des pratiques différentes. Un signal technique n'est pas une preuve que tous les usages possibles sont empêchés.
Copier une configuration sans contexte. Une règle adaptée à un site documentaire peut être inappropriée pour une boutique ou une application. Lis les spécifications et vérifie l'état actuel.
Changer plusieurs paramètres simultanément. Si tu modifies l'exploration, les directives de page et les permissions d'accès dans la même opération, tu compliques le diagnostic. Priorise les risques et conserve un journal des décisions.
Ignorer la responsabilité éditoriale. Une politique de contenu ne relève pas toujours du seul développeur. Le propriétaire du site doit comprendre les arbitrages et les approuver.
FAQ : robots.txt et entraînement IA
Le nouveau contrôle partagé fonctionne-t-il déjà partout ?
Non. Le 30 octobre 2026, Google a annoncé un projet de prise en charge visé pour 2027. Le soutien des autres fournisseurs et les détails de standardisation restent à suivre.
Bloquer un robot empêche-t-il l'accès à mes documents ?
Non. robots.txt n'est pas un contrôle d'accès. Les documents privés nécessitent une authentification et des autorisations adaptées.
Peut-on rester visible dans Google tout en exprimant une préférence d'entraînement ?
Les usages de recherche et d'entraînement doivent être distingués. Les effets exacts dépendent des contrôles et des produits concernés ; consulte leur documentation avant de décider.
Dois-je modifier mon site aujourd'hui ?
Pas nécessairement. Commence par inventorier tes contenus, vérifier tes objectifs et documenter les contrôles existants. Une modification doit répondre à un besoin précis.
Peut-on proposer un audit de ces paramètres en freelance ?
Oui, comme prestation de diagnostic et de documentation, à condition de définir clairement son périmètre, ses limites et les compétences nécessaires à toute intervention technique ou juridique.
Ressources complémentaires et prochaine étape
Trois ressources primaires permettent d'aller plus loin : l'annonce de Google du 30 octobre 2026, la documentation Google sur les fonctionnalités IA et les contrôles de site et le journal des changements de l'infrastructure d'exploration. Elles n'ont pas toutes le même rôle : la première présente un projet, la deuxième explique des contrôles existants et la troisième documente les évolutions techniques.
La prochaine action n'est pas de copier une règle dans ton serveur. Choisis une catégorie de pages, remplis la fiche SOURCE et note ce que tu dois encore vérifier. Si tu construis une activité autour du web, retrouve les parcours et les guides de DO TO DAY pour transformer cette réflexion en une étape concrète, sans promettre un résultat automatique.
Sources et limites
Mécanisme partagé annoncé pour 2027, non présenté comme universellement actif. Exemple commercial fictif. Aucun conseil juridique ni garantie SEO.
- Google Search Central — Supporting a shared AI training control
- Google Search Central — AI features and your website
- Google Crawling — Documentation changelog
Passer à l’action
Transforme ta lecture en prochaine étape.
La mission Service de DO TO DAY t’aide à définir une offre claire, fixer ton prix et trouver tes premiers clients.
Commencer gratuitementBêta gratuite. Les résultats dépendent du projet et de son exécution.