Automatisation contrôlée
Agent IA sur ordinateur : tester un logiciel sans API
Publié le
Un agent peut désormais agir dans certains logiciels sans API. Avant de vendre cette capacité, apprends à tester une tâche limitée, ses permissions et son résultat réel.
Pourquoi les agents IA peuvent désormais utiliser des logiciels sans API
Pendant longtemps, automatiser un logiciel signifiait chercher une API, exporter un fichier ou reproduire des clics avec un script fragile. Une autre approche progresse : un agent peut observer une interface et agir dessus comme un utilisateur, sous certaines conditions. Cela ne signifie pas qu'il comprend toutes les conséquences de ses actions. Un bouton mal identifié, une fenêtre inattendue ou un changement d'interface peuvent suffire à détourner une opération.
La documentation officielle de GitHub décrit une fonction de computer use pour Copilot, disponible en préversion publique dans des sessions locales sur macOS et Windows. Elle permet de lire le contenu accessible d'une application, cliquer, saisir du texte, faire défiler et naviguer entre des fenêtres. Elle vise notamment les logiciels anciens sans API ni interface en ligne de commande. Cette description est une capacité annoncée, pas une preuve de fiabilité universelle.
Pour un indépendant, l'occasion n'est donc pas de promettre « j'automatise n'importe quel logiciel ». Elle consiste à repérer une tâche répétitive, à préparer un essai contrôlé et à déterminer si l'automatisation apporte réellement quelque chose. La question commerciale vient après la question opérationnelle : quelle tâche précise mérite d'être testée, et avec quels garde-fous ?
Choisir une tâche suffisamment petite pour être testée
Commence par un travail qui possède un début, une fin et un résultat visible. « Gérer le back-office » est trop vaste. « Reporter cinq références fictives dans un tableau de suivi et signaler les champs manquants » est beaucoup plus utile pour apprendre. Tu peux observer ce qui se passe et comparer le résultat attendu au résultat obtenu.
Privilégie une tâche non destructive : lire un statut, préparer un brouillon, copier des informations fictives ou produire une liste de vérification. Écarte au départ les paiements, suppressions, modifications de droits, commandes et envois à des clients. Ces actions présentent des conséquences plus difficiles à corriger. Même lorsqu'un agent demande une confirmation, une validation trop rapide peut laisser passer une erreur.
Un bon premier scénario tient sur une feuille : application concernée, état initial, cinq opérations autorisées, opérations interdites, résultat attendu, personne chargée de vérifier. Si tu ne peux pas écrire ce scénario simplement, le périmètre est probablement trop large. Cette discipline rejoint la logique de validation d'une idée de business : on vérifie une hypothèse avant de construire une offre complète.
La règle du résultat vérifiable
Un résultat vérifiable n'est pas « l'agent semble avoir terminé ». C'est un état que tu peux constater indépendamment : les lignes attendues existent, les valeurs correspondent à la source, aucune ligne supplémentaire n'a été créée et aucun message n'a été envoyé. Prépare ces critères avant de lancer l'essai.
La méthode PILOTE pour cadrer un essai
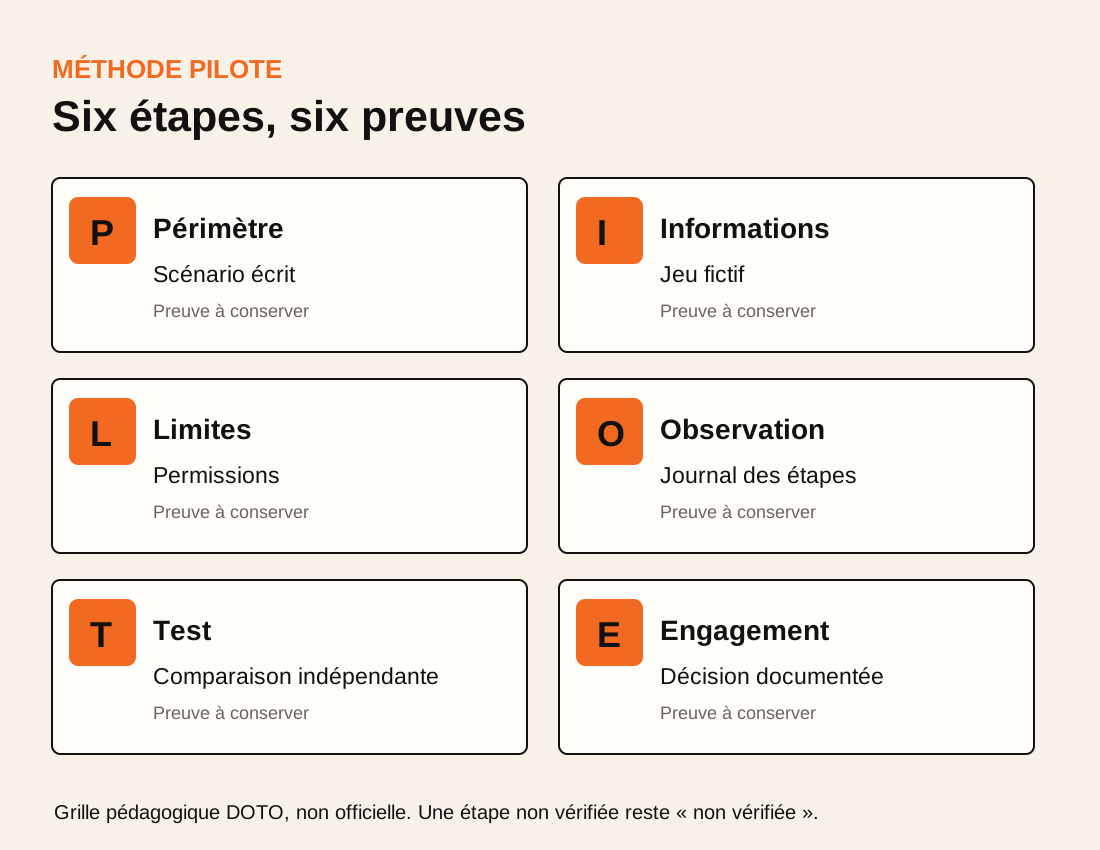
Voici une grille de travail créée pour cet article. Elle n'est ni une norme officielle ni une certification. Son intérêt est de transformer une idée séduisante en expérience reproductible.
| Étape | Question | Preuve à conserver |
|---|---|---|
| P, Périmètre | Quelle tâche et quelles applications ? | Scénario écrit |
| I, Informations | Quelles données l'agent peut-il voir ? | Jeu de test fictif |
| L, Limites | Quelles actions sont interdites ? | Règles et permissions |
| O, Observation | Que fait réellement l'agent ? | Journal des étapes |
| T, Test | Le résultat correspond-il aux attentes ? | Comparaison indépendante |
| E, Engagement | Faut-il poursuivre ou arrêter ? | Décision documentée |
La première étape évite l'automatisation sans objectif. La deuxième réduit le risque d'exposer des données confidentielles. La troisième fixe les frontières avant que l'agent commence à agir. La quatrième empêche de confondre une démonstration fluide avec un processus fiable. La cinquième produit des éléments contrôlables. La dernière oblige à décider plutôt qu'à empiler des essais.
Ne donne pas à chaque étape une note arbitraire pour obtenir un score flatteur. Si une information manque, indique « non vérifié ». Une décision prudente peut être de refaire un test plus petit. C'est parfois le meilleur résultat d'une première séance.
Ce qu'il faut écrire avant de commencer
Écris aussi une procédure d'arrêt : touche ou commande d'interruption, personne responsable, état à restaurer et endroit où vérifier que rien n'a été transmis. Dans sa documentation, GitHub explique comment interrompre une opération et revoir les applications autorisées. Les commandes précises dépendent de l'interface utilisée ; consulte les instructions de ton outil avant l'essai.
Permissions : distinguer voir, préparer et exécuter
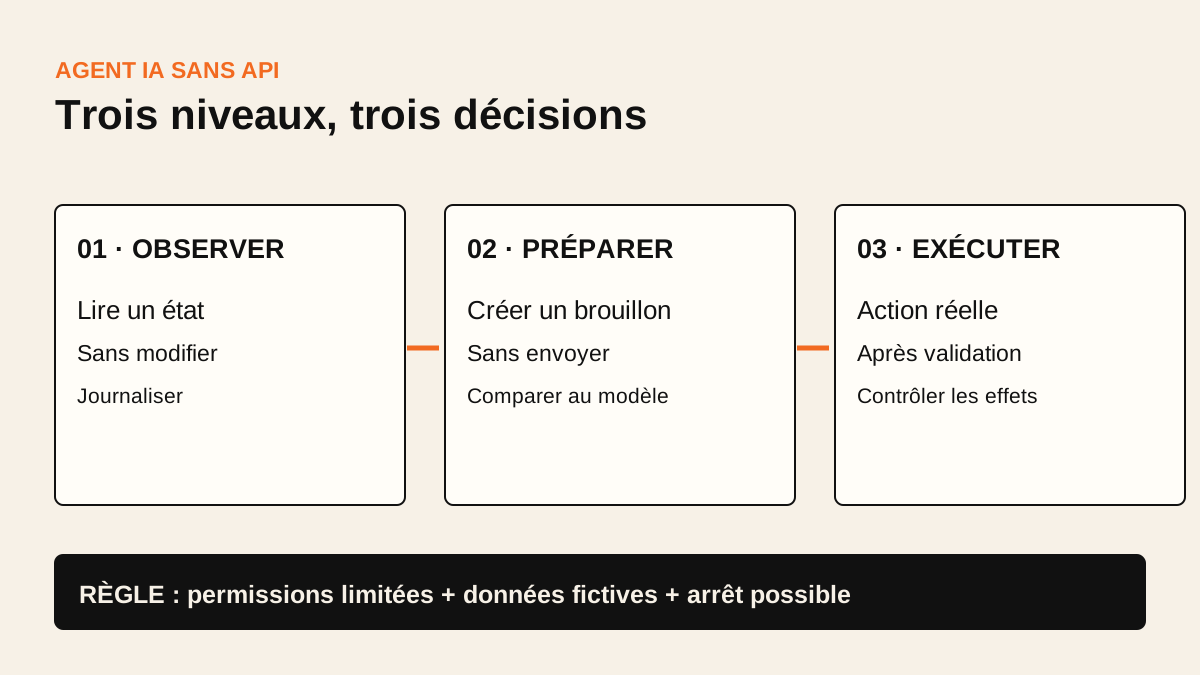
Un agent qui peut lire une fenêtre n'a pas nécessairement besoin de modifier ce qu'elle contient. Sépare trois niveaux : observation, préparation d'un brouillon et action effective. Tu peux autoriser le premier pendant le diagnostic, le deuxième lors d'un pilote, puis décider si le troisième est justifié. Ne saute pas directement à l'exécution autonome.
La documentation GitHub indique que le contrôle des applications dépend des réglages de permissions et que certaines autorisations peuvent être enregistrées pour des sessions futures. Une approbation persistante mérite une revue spécifique. Retirer une application de la liste des autorisations futures n'annule pas nécessairement une session déjà ouverte. Il faut aussi arrêter cette session lorsque c'est nécessaire.
Ne partage pas le mot de passe principal du client pour gagner quelques minutes. Préfère un environnement de démonstration, un compte de test et des permissions limitées lorsque le logiciel le permet. Une session ouverte sur un poste réel peut afficher des notifications, documents ou onglets sans rapport avec la mission. Ferme les applications sensibles et prépare un espace de travail isolé.
Si tu interviens chez un client, fais préciser par écrit le logiciel autorisé, les catégories de données accessibles, les actions permises et la durée du test. Ce cadrage ne remplace pas un conseil juridique ou une analyse de protection des données. Il rend néanmoins les responsabilités moins ambiguës.
Préparer des données fictives qui révèlent les erreurs
Un essai sur une seule ligne parfaite n'apprend presque rien. Construis un petit jeu de données fictives avec des situations différentes : un enregistrement complet, un champ vide, un doublon, une date ambiguë, un caractère accentué et une information contradictoire. Note la réponse attendue pour chaque cas avant d'exécuter l'agent.
Par exemple, un formulaire de devis contient un nom d'entreprise fictif, un service demandé et une date souhaitée. Lorsque la date manque, le bon comportement peut être de laisser le champ vide et de demander une validation. Inventer une date pour terminer le formulaire constitue une erreur, même si l'interface affiche ensuite un message de succès.
Ne réutilise pas de véritables coordonnées clients dans un prototype sans justification et protections adaptées. Pour un premier essai, des noms inventés suffisent. Si tu dois ensuite tester des données réelles, définis une base légitime, des accès adaptés et une durée de conservation. La facilité technique ne dispense pas de ces décisions.
Garde une copie du tableau initial et du tableau attendu. Après l'exécution, compare les deux indépendamment du résumé produit par l'agent. Une phrase comme « tout est terminé » ne vaut pas contrôle. La preuve est dans les champs et les actions réellement observés.
Cas pratique fictif : un atelier qui travaille avec un vieux logiciel
Imagine Léa, indépendante qui accompagne un petit atelier de réparation. L'équipe utilise un logiciel de gestion ancien, sans API documentée. Chaque vendredi, une personne relève les interventions en attente pour préparer un compte rendu. Léa envisage un agent capable de lire l'écran et de préparer ce récapitulatif.
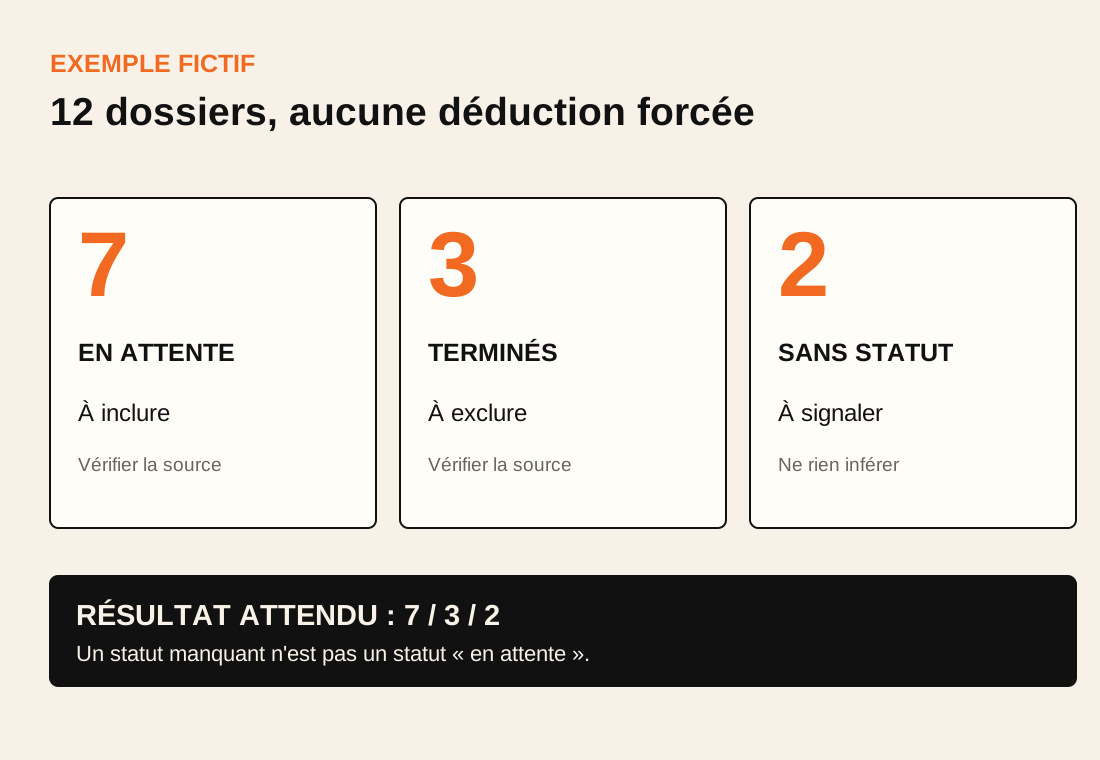
Tout ce qui suit est fictif. L'atelier de démonstration contient douze dossiers inventés. Sept sont marqués « en attente », trois « terminés » et deux n'ont pas de statut. Le résultat attendu n'est pas une liste de douze interventions à relancer : les dossiers terminés doivent être exclus et les deux statuts absents doivent être signalés.
Léa commence par un compte de démonstration. Elle demande uniquement la lecture des fiches et la préparation d'un tableau séparé. Elle interdit les modifications du logiciel, les envois de messages et la suppression de dossiers. Une personne observe le déroulement et conserve le tableau initial.
Au premier essai fictif, l'agent classe correctement les sept dossiers en attente mais attribue par erreur un statut aux deux dossiers incomplets. Le tableau final paraît propre ; il est pourtant faux. Léa corrige son instruction : « Si le statut est absent, écris statut inconnu et n'infère rien. » Elle recommence avec un nouveau jeu de test.
Le second essai fictif produit la répartition attendue. Cela ne prouve pas que l'agent fonctionnera toujours. Léa consigne les conditions de réussite, les erreurs précédentes et les changements d'interface susceptibles de perturber le processus. Elle n'a encore ni automatisé une production réelle ni vendu une prestation.
Ce cas montre le bon ordre : comprendre la tâche, préparer les limites, observer les erreurs, puis décider si un pilote client est pertinent. Pour réfléchir à une éventuelle offre, elle peut ensuite calculer le prix d'une prestation à partir du temps réellement consacré.
Pourquoi ça marche : remplacer la promesse par une preuve
Cette méthode fonctionne comme cadre de décision parce qu'elle réduit le nombre de variables. Si tu modifies simultanément l'application, le jeu de données, les instructions et les permissions, tu ne sauras plus expliquer une erreur. En conservant le même scénario, tu peux comparer deux exécutions et identifier ce qui a changé.
Le cadre distingue aussi la capacité technique de la valeur économique. Un agent peut réussir une tâche sans qu'elle mérite d'être automatisée. Si la préparation, la supervision et la correction prennent plus de temps que l'opération manuelle, l'offre n'a peut-être pas de sens. Il faut mesurer le travail complet, pas seulement la durée pendant laquelle l'agent clique.
Enfin, la validation humaine protège la relation avec le client. Tu peux présenter un résultat incomplet avec des réserves explicites. C'est plus professionnel qu'une démonstration spectaculaire qui cache les erreurs. L'objectif est de réduire un problème réel, pas de produire une vidéo impressionnante.
Tu peux réutiliser cette logique pour choisir une idée de business en ligne : une demande répétée, une tâche accessible et une preuve d'utilité comptent davantage que la nouveauté de l'outil.
Comment l'appliquer dès aujourd'hui en 90 minutes
Voici une séance de travail indicative, pas une garantie de résultat. Adapte la durée à ton niveau et aux contraintes de l'application. Les minutes proposées sont des repères de planification.
Pendant les quinze premières minutes, décris une seule tâche répétitive. Écris ce qui déclenche l'opération, les données nécessaires et le résultat attendu. Demande-toi aussi ce qui se passe si la tâche échoue. Si l'échec peut envoyer un mauvais paiement ou divulguer une information, choisis un autre scénario pour commencer.
Consacre ensuite vingt minutes à préparer des données fictives et une copie de référence. Ajoute au moins un cas incomplet et un cas ambigu. Note la réponse attendue sans demander à l'agent de la deviner.
Pendant quinze minutes, définis les permissions et les interdictions. Identifie les fenêtres accessibles, les actions autorisées, les boutons dangereux et la procédure d'arrêt. Vérifie les réglages de l'outil sur la documentation officielle.
Utilise vingt minutes pour exécuter un essai observé. Ne laisse pas l'agent agir seul sur un compte réel. Consigne les étapes, les erreurs et les demandes de confirmation. Arrête l'essai si l'interface ou les données ne correspondent plus au scénario.
Réserve les vingt dernières minutes à la comparaison des résultats. Classe chaque écart : omission, invention, mauvaise catégorie, action non autorisée ou blocage technique. Décide ensuite de refaire le test, réduire le périmètre ou arrêter. La bonne sortie de séance est une décision argumentée, pas nécessairement une automatisation.
Si tu n'as pas accès à un ordinateur compatible, prépare simplement le scénario et le jeu de données. Tu auras déjà avancé sans dépenser pour un outil inadapté.
Erreurs courantes à éviter avant une prestation
La première erreur consiste à confondre préversion publique et produit stable. Une fonction annoncée peut évoluer, être indisponible selon le système ou exiger des autorisations spécifiques. Vérifie les conditions actuelles plutôt que de construire ton offre sur une capture d'écran.
La deuxième consiste à accorder une permission permanente pour un essai ponctuel. Revois les approbations enregistrées et ferme les sessions inutiles. La troisième est de laisser l'agent traiter des informations personnelles alors que des données fictives suffiraient.
La quatrième erreur consiste à mesurer seulement le temps d'exécution. Ajoute le temps de préparation, de contrôle, de correction et de maintenance. Un logiciel ancien peut changer de disposition après une mise à jour ; un script de clics comme un agent visuel peut alors se tromper.
La cinquième consiste à vendre une « automatisation totale » sans procédure de secours. Prévois un mode manuel, un responsable de validation et une façon d'interrompre le processus. Une prestation limitée et vérifiable inspire davantage confiance qu'une promesse illimitée.
Enfin, ne confonds pas le consentement d'un responsable avec l'autorisation de tout faire. Les droits du logiciel, la confidentialité des dossiers et les règles internes restent applicables. Quand le cadre n'est pas clair, ne lance pas le test.
Transformer un essai en offre de service réaliste
Si plusieurs essais réussissent, tu peux envisager une offre de diagnostic plutôt qu'un abonnement d'automatisation immédiat. Son livrable peut comprendre une cartographie de la tâche, une démonstration sur données fictives, une liste de risques et une recommandation : automatiser, simplifier le processus ou rester manuel.
Écris clairement ce qui n'est pas inclus : accès à la production, manipulation de paiements, envoi automatique, maintenance continue et garantie de fonctionnement sans supervision. Le client doit pouvoir comprendre ce qu'il achète et ce qu'il devra encore faire lui-même.
Pour fixer un prix, compte la préparation, les échanges, la création des tests, les vérifications et la restitution. Si tu dois prospecter, commence par un secteur précis et une tâche documentée. Le guide sur les premiers clients sans publicité peut t'aider à organiser cette démarche sans envoyer des messages génériques.
Avant de promettre un gain, demande au client de mesurer la durée et les erreurs du processus actuel. Compare ensuite avec un pilote réel autorisé. Sans cette mesure, toute affirmation de productivité serait une hypothèse. Note également les coûts d'outils et les contraintes de licence.
Tu peux refuser une mission trop risquée. Un bon service ne consiste pas à accepter toutes les automatisations ; il consiste à choisir celles que tu peux expliquer, contrôler et maintenir.
FAQ : les questions avant de laisser un agent agir
Un agent IA peut-il utiliser un logiciel sans API ?
Oui, certains outils disposent de fonctions de contrôle d'interface capables de lire l'écran et d'interagir avec des applications. Leur disponibilité, leurs permissions et leur fiabilité dépendent du produit et du système.
Peut-on tester gratuitement ?
Tu peux préparer gratuitement le scénario et les données fictives. L'exécution dépend de l'accès à un outil compatible, de ses conditions et de son éventuelle facturation.
Faut-il laisser l'agent cliquer sans surveillance ?
Pas pour un premier pilote. Observe les actions, limite les permissions et exige une validation humaine avant les opérations ayant des conséquences externes.
Comment savoir si le test a réussi ?
Compare le résultat avec une référence écrite avant l'essai. Vérifie les données, les omissions, les actions supplémentaires et le respect des interdictions.
Peut-on vendre ce service à une PME ?
Tu peux proposer un diagnostic ou un pilote cadré. La valeur, le prix et la possibilité d'automatiser doivent être validés auprès d'un client réel, sans promesse de résultat.
Ressources complémentaires et prochaine étape
Pour comprendre les fonctions et limites du contrôle d'ordinateur, consulte la documentation officielle de GitHub Copilot. Pour la configuration en ligne de commande, utilise le guide GitHub Copilot CLI. L'annonce GitHub du 28 octobre 2026 explique le contexte de cette évolution dans les outils de développement.
Ne commence pas par chercher le logiciel le plus impressionnant. Choisis une tâche, écris ce qui est autorisé, prépare des données fictives et observe un essai. Si le résultat est utile et contrôlable, tu pourras envisager un pilote plus ambitieux.
Pour organiser la suite sans multiplier les projets, explore DO TO DAY. Tu peux y découvrir des pistes de business et des parcours guidés, puis revenir à ton prochain livrable concret. Le bon objectif pour aujourd'hui n'est pas « automatiser une entreprise ». C'est obtenir une preuve claire sur une seule tâche.
Sources et limites
Les exemples sont fictifs. La disponibilité du computer use dépend du système et du produit ; aucun gain économique n'est garanti.
- GitHub Docs — Computer use dans l'application Copilot
- GitHub Docs — Computer use dans Copilot CLI
- GitHub Changelog — Copilot dans VS Code, 28 octobre 2026
Passer à l’action
Transforme ta lecture en prochaine étape.
La mission Agence IA de DO TO DAY t’aide à choisir un cas d’usage, cadrer une offre pilote et préparer ta prospection, étape par étape.
Commencer gratuitementBêta gratuite. Les résultats dépendent du projet et de son exécution.